180 מיליארד מנצחים 2.8 טריליון: Darwin של VIDRAFT בראש המודלים הפתוחים במתמטיקה ומדעים
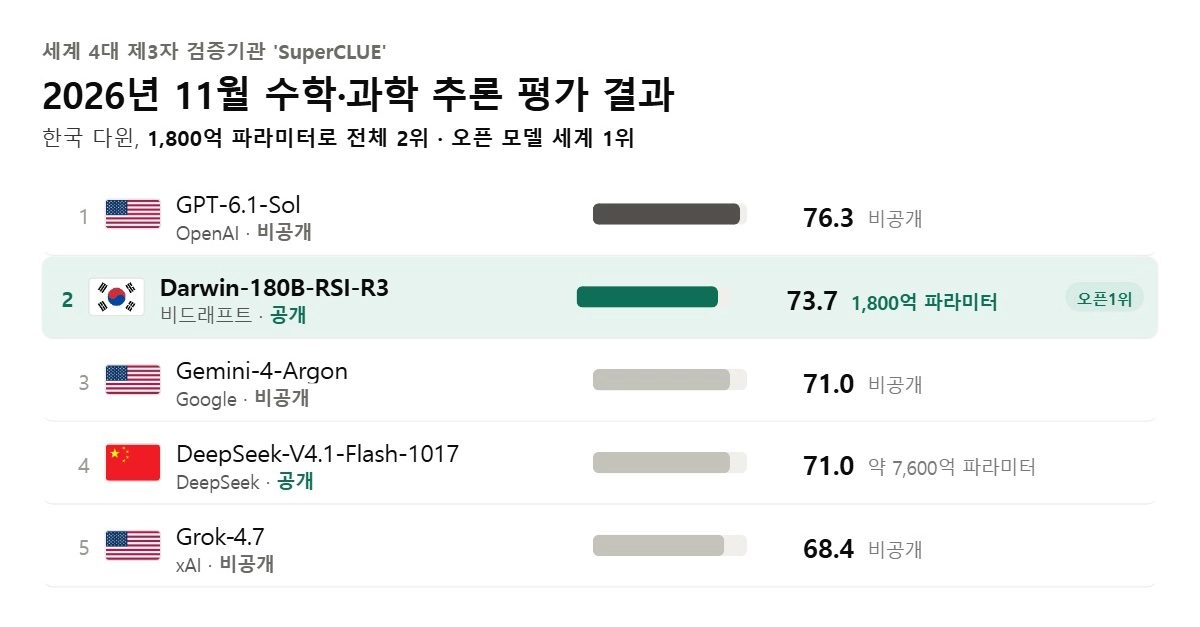
מודל של 180B פרמטרים שמנצח מודל גדול ממנו פי 15 ויותר במסלול reasoning מצטרף לנושא היעילות של החודש: גם Qwen4-Max קיצץ בפרמטרים הפעילים, ו-Mistral Large 4 מפעיל רק 52B מתוך טריליון פרמטרים.
SuperCLUE הוא סט benchmarks בהובלה סינית, ומסלול ה-reasoning במתמטיקה ומדעים שלו בודק פתרון בעיות רב-שלבי ולא איכות צ'אט כללית. הסיומת 'RSI' מרמזת ש-VIDRAFT השתמשה בלולאת post-training בסגנון recursive self-improvement, אבל הדיווח כמעט לא מפרט את המתודולוגיה. וצריך לסייג: מדובר במסלול אחד בטבלה אחת, שהגיע דרך repost ב-dev.to של כתבה מ-ZDNet Korea. ניצחונות ב-reasoning ממוקד לא עוברים בדרך כלל לקוד או למשימות agent, וזיהום benchmark הוא סיכון קבוע. Kimi K3.1 Pro נשאר כללי הרבה יותר.
ובכל זאת, זה סימן משמעותי לסצנת ה-AI הקוריאנית ולמפתחים במחנה המודלים הפתוחים שצריכים reasoning חזק בגודל שנכנס לכמה GPUs. לעקוב: שחזור עצמאי, דוח טכני ותוצאות ב-Artificial Analysis או ב-LMArena.