NVIDIA משיקה את Nemotron 3 Diarization — מקום ראשון עם שיעור שגיאה של 14.72%
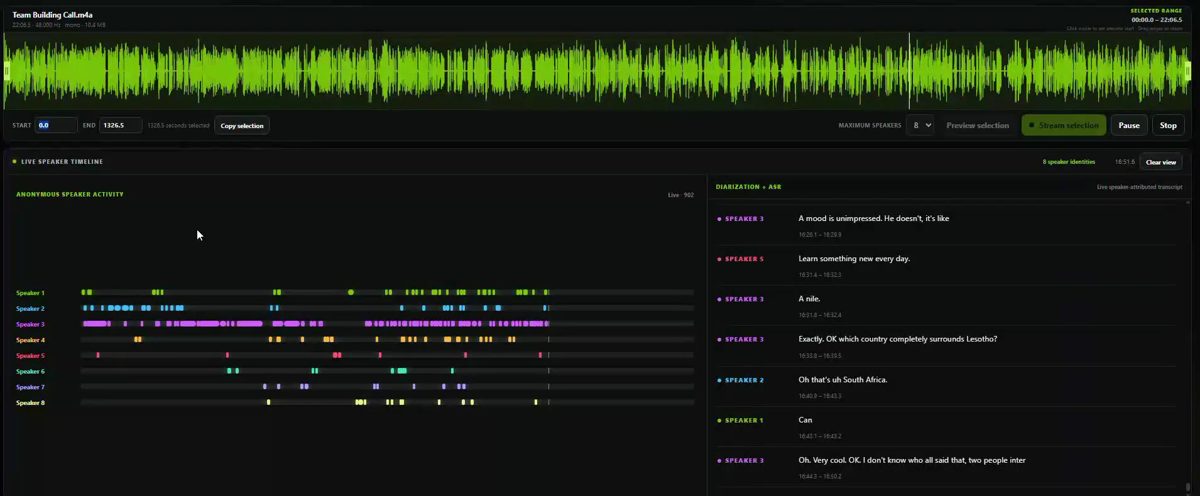
NVIDIA השיקה מודל דיבור קטן אך מתקדם במיוחד: Nemotron 3 Diarization, שתפס את המקום הראשון ב-Diarization-Bench עם שיעור שגיאה של 14.72% — נמוך בערך ב-24% מהמתחרה הקרוב ביותר. Speaker diarization, כלומר קביעה של 'מי דיבר ומתי', הוא צוואר בקבוק מתמשך בתמלול פגישות, ניתוח שיחות ו-voice agents מרובי-דוברים, והדיבור החופף הוא המקרה הקשה ביותר שלו.
עם 100M פרמטרים בלבד, המודל קליל בכוונה, מטפל בעד שמונה דוברים ועוקב אחר קולות חופפים — מה שהופך אותו לבר-deploy על חומרה צנועה. NVIDIA שחררה אותו ב-Hugging Face עם demo חי ב-Hugging Face Spaces, וקישרה את ההכרזה לחומרה של Pollen Robotics — ה-Reachy Mini וה-DGX Spark.
השחרור משתלב במהלך הרחב יותר של NVIDIA סביב המודלים הפתוחים של Nemotron — גם Nemotron 3 Super 120B זמין ב-Amazon Bedrock ל-workflows של coding agents — כשהחברה בונה ecosystem של תוכנה ומודלים מעל הדומיננטיות שלה בסיליקון. ההקשר הקהילתי מעורב: SemiAnalysis ומפתחי open-source הזהירו מפני תלות בספק בכל הנוגע למאיצים אחרי העסקה הגדולה של NVIDIA עם Hugging Face, ומביטים לעבר חלופות כמו ModelScope. ועדיין, מודל diarization קטן, מוביל ופתוח הוא תוספת קונקרטית ושימושית. מה לעקוב: עמידות בעולם האמיתי מול אודיו רועש, במבטאים ומרחוק — בניגוד ל-benchmark.