פי 8 מהר יותר על Blackwell: GPT-6 Astra Ultrafast מגיע ל-API ול-Bedrock
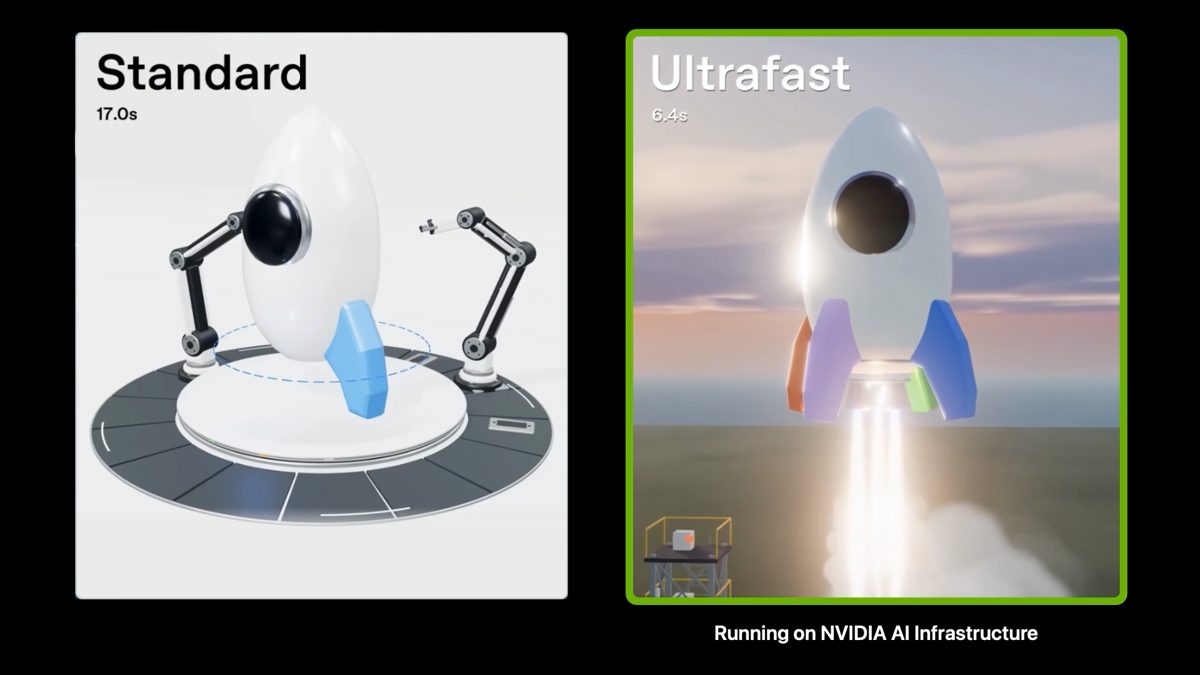
גם כש-OpenAI גנזה את הגרסה הבאה של Astra, הגרסה הנוכחית האיצה משמעותית. לפי הבלוג של NVIDIA, GPT-6 Astra Ultrafast זמין עכשיו ב-API של OpenAI ולמשתמשים זכאים ב-ChatGPT Work וב-Codex, ומייצר tokens מהר עד פי 8 מ-Astra Standard. בנפרד, AWS פרסמה שכבת UltraFast פרימיום ל-GPT-6 Astra ב-Bedrock.
ההאצה מגיעה מאופטימיזציות inference שנבנו ל-Blackwell, ארכיטקטורת ה-GPU הנוכחית של NVIDIA. סביר שמדובר ב-kernels בדיוק נמוך, speculative decoding וכיוונון רוחב פס זיכרון שמשתלמים רק על החומרה הזו. התוצאה היא שכבת מהירות ולא מודל חדש: אותו מודל, מוגש מהר יותר במחיר פרימיום. למשתמשי Codex זה משנה בפועל, כי לולאות קוד מבוססות agent משרשרות הרבה יצירות, וזמן ההמתנה מצטבר.
זה הסבב האחרון במרוץ שכבות המהירות. ל-Anthropic ול-Google יש מצבי fast, וספקי inference ייעודיים כמו Cerebras ו-Groq בנו את כל ההצעה שלהם על tokens לשנייה. הקישור של Ultrafast ל-Blackwell גם מחזק את הקשר של OpenAI עם NVIDIA, דווקא בשבוע ש-OpenAI נעדרה בולטות מקואליציית ה-agent safety של NVIDIA: היחסים מסחריים גם כשהחברות חלוקות על governance. הסתייגויות: 'פי 8' הוא נתון שיא ביחס ל-Standard ולא תפוקה מובטחת, ותמחור השכבה לא מופיע במקורות. מפתחים ב-HN כבר כועסים על הידוק המכסות ב-ChatGPT Pro, ושכבה של 'שלם יותר על מהירות' עלולה לחדד את הטענה ש-OpenAI גובה כסף על גישה ולא על יכולת. כדאי לעקוב אחרי מדידות אמיתיות של tokens לשנייה וגרסאות Ultrafast ל-GPT-6.1 Sol.
