DeepSeek-V4.1-Flash מהמר על encoder-decoder סיבתי כדי לחתוך את עלויות ה-cache של agents
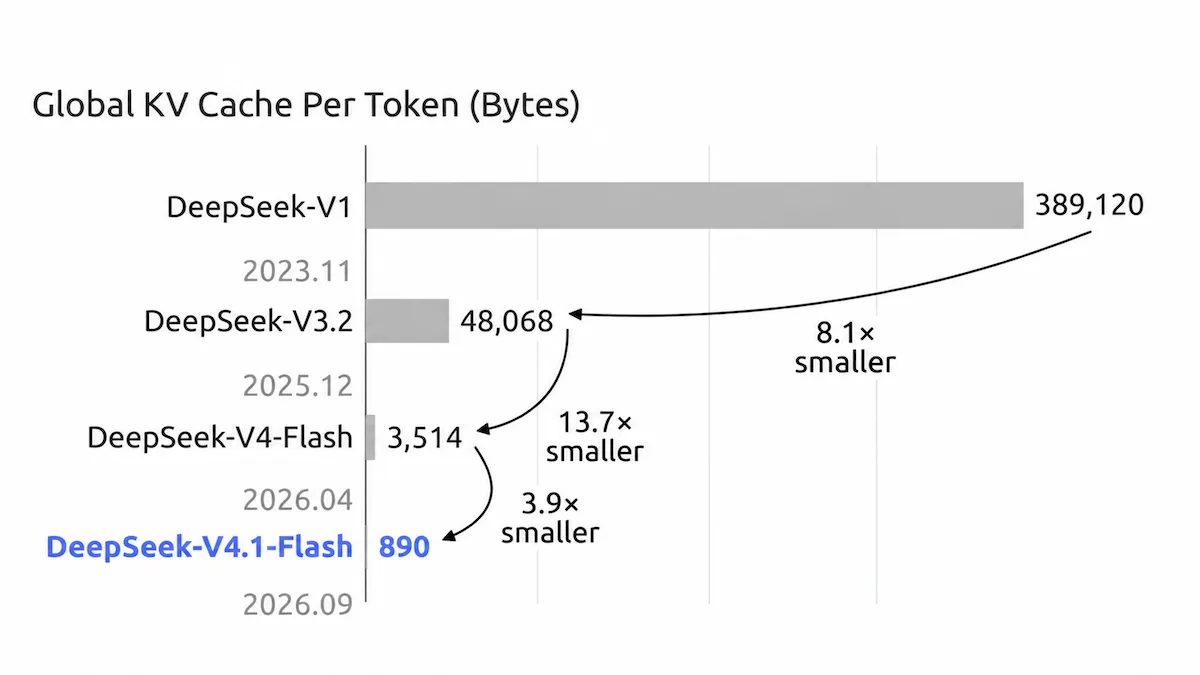
מודל ה-Flash החדש של DeepSeek תוקף ברמת הארכיטקטורה את גורם העלות המרכזי בעומסי agents: קריאה חוזרת ונשנית של הקשרים ענקיים. V4.1-Flash משתמש בתכנון causal encoder-decoder: הוא מפעיל 8B פרמטרים לכל token בשלב ה-prefill, כשהקלט מעובד, ו-16B בשלב ה-decode, כשהפלט נוצר. האסימטריה הזו מצמצמת קריאות cache במשימות agent כבדות-קלט, שבהן פלטי כלים והקשר של ה-repository גדולים בהרבה מהטקסט שנוצר.
המפרט מרשים למודל פתוח: חלון הקשר של 1,048,576 token, רישיון MIT, ו-74.2% ב-DeepSWE v1.1. הציון ממקם אותו בין Grok 4.7 של xAI עם 71.0% לבין Gemini 4 Argon של Google עם 77.9% באותו benchmark. ב-The Batch של DeepLearning.AI כתבו ש-Flash "שוב עוקף את Pro". DeepInfra כבר מגישה אותו ב-fp8.
מפתחים שיבחו את השילוב של רישיון וחלון הקשר כאופציה זולה ללולאות agent ארוכות. הוא מתחרה ישירות בתמחור ה-cached input שהוזיל עכשיו OpenAI ל-GPT-6.1 Sol. DeepSeek גם השיקה בתצוגה מקדימה ציבורית את DeepSeek Harness, אפליקציית דסקטופ לעבודה מקומית, ל-macOS, Windows ו-Linux.
הסתייגות אחת: תוצאות DeepSWE מדווחות על ידי הספקים עצמם, והאמינות של agents בעולם האמיתי לא תמיד תואמת לדירוגי ה-benchmark. שרשור ב-r/DeepSeek על התנהגות של "לולאה אינסופית" מרמז שעדיין יש קצוות לא מלוטשים. כדאי לעקוב אחרי הערכות עצמאיות, והאם V4.1-Flash ירוץ ביעילות על חומרת Huawei Ascend דרך TileLang.