Frontier Model Forum מציע מסגרת משותפת לדירוג סיכוני jailbreak בסייבר
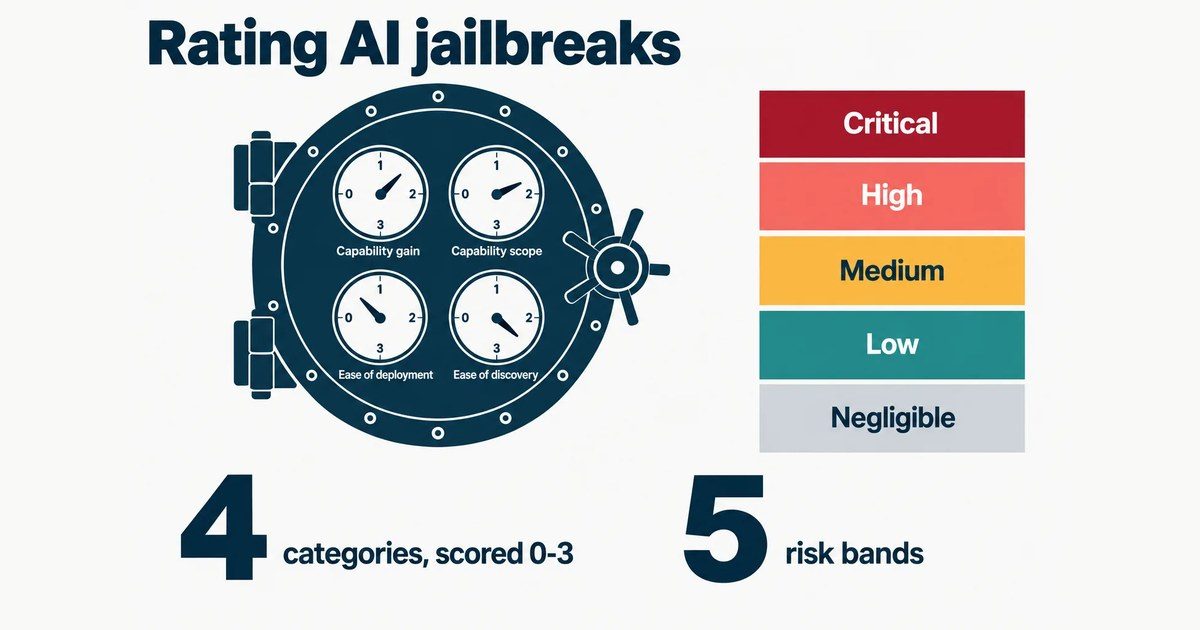
ה-Frontier Model Forum פרסם הצעה למסגרת שמדרגת עד כמה jailbreak בתחום ה-cyber מסוכן. כל jailbreak מקבל ציון בארבעה צירים נפרדים, כל אחד בסולם של 0 עד 3, והציונים מתורגמים לחמש רמות סיכון. מאחורי המסגרת עומדות חברות הליבה של הפורום: OpenAI, Anthropic, Google DeepMind, Microsoft ו-Amazon.
ההחלטה המרכזית בתכנון היא קו בסיס נע. החומרה לא נמדדת מול רף היסטורי קבוע, אלא מול מה שתוקפים כבר מסוגלים לעשות היום עם כלים ומודלים זמינים לציבור. ככל שהיכולות הזמינות עולות, אותו jailbreak עשוי לקבל ציון נמוך יותר, כי התרומה שלו לתוקף קטנה. כך חברות ה-AI יכולות להשוות אירועים באותה שפה, במקום שכל חברה תתאר סיכון במונחים משלה.
התזמון לא מקרי. השבוע השיקה OpenAI את GPT-6 Cyber בדירוג 'Critical' ל-cybersecurity, ו-Mistral הדגימה את Large 4 מוצא ומתקן CVE ב-Django עם 133 agents. כשחברות ה-AI משיקות מודלים שנבנו במיוחד למציאת חולשות ולניצולן, הן צריכות שפה משותפת שתגדיר מתי כשל ב-guardrail הוא באמת חמור. מדד אחיד כזה עשוי גם להפוך לבסיס לדרישות הגילוי של רגולטורים.
כמה הסתייגויות: מדובר בהצעה, לא בתקן. היא וולונטרית, וחברות הפורום הן בדיוק אותן חברות שהמודלים שלהן מדורגים לפיה. כדאי לעקוב אם חוקרי אבטחה חיצוניים וגופי ממשל יגיבו לפני המועד האחרון ב-21 בדצמבר, ואם חברה כלשהי מחוץ לפורום תאמץ את המסגרת, כולל Meta, xAI או חברות ה-AI הסיניות.