Grok Imagine מוסיף יצירת סצנות קולנועיות מלאות עם אודיו מסונכרן
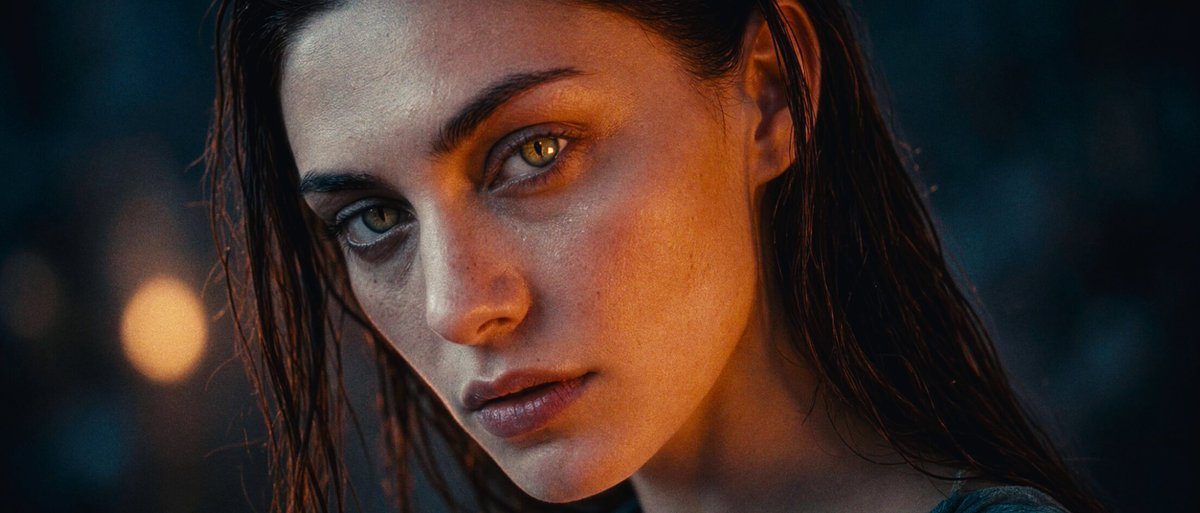
xAI הרחיבה את Grok Imagine ליצור סצנות סרט באיכות קולנועית מלאה מ-prompts, בהתבסס על יותר משנה של פיתוח יצירת וידאו. הפיצ'ר תומך ב-text-to-video, image-to-video, ועריכת וידאו מבוססת-prompt, ומייצר קליפים של עד 15 שניות — הניתנים להרחבה ל-30 — עם אפקטים קוליים מסונכרנים, אודיו סביבתי ודיאלוג. יכולת האודיו המסונכרן היא המבדל הבולט, שנע מעבר ליצירת קליפים אילמים לכיוון סצנות שלמות עם נופי צליל.
לצד פיצ'ר הווידאו, xAI תיעדה את Grok Imagine Image 2.0, מודל יצירת תמונות שמוסיף פרמטר איכות מפורש שנותן למשתמשים שליטה ישירה על ה-tradeoff בין נאמנות למהירות. יחד, השחרורים משלימים את ה-stack של המדיה היצירתית של xAI, ומשלימים את הדחיפה שלה ל-voice ותמלול השבוע.
מבחינה תחרותית, יצירת סצנות מלאות עם דיאלוג וסביבה מסונכרנים מכניסה את Grok Imagine להתמודדות ישירה עם Sora של OpenAI, Veo של Google ו-Runway במרוץ ה-text-to-video המסלים במהירות, שבו סנכרון אודיו-וידאו הפך לחזית החדשה אחרי רזולוציה ואורך. השילוב ל-Grok ecosystem הרחב יותר — וההפצה של X — נותן ל-xAI קהל מובנה ו-loop ויראלי שיריבים צריכים לקנות או לבנות. ההסתייגויות הן הרגילות לדור הזה של מודלי וידאו: קליפים של 15 עד 30 שניות נשארים קצרים לשימוש פרודקשן אמיתי, שליטה ב-prompt ועקביות זמנית קשות לשיפוט מדמואים, והשיטפון של יצירה קולנועית קלה מעצים חששות מ-deepfakes ומדיה סינתטית, שהעמדה הרופפת של xAI לגבי תוכן עושה מעט כדי להפיג.