בתוך Prometheus: Meta סיימה את שלב הג׳יגוואט הראשון בדרך למיליון GPUs
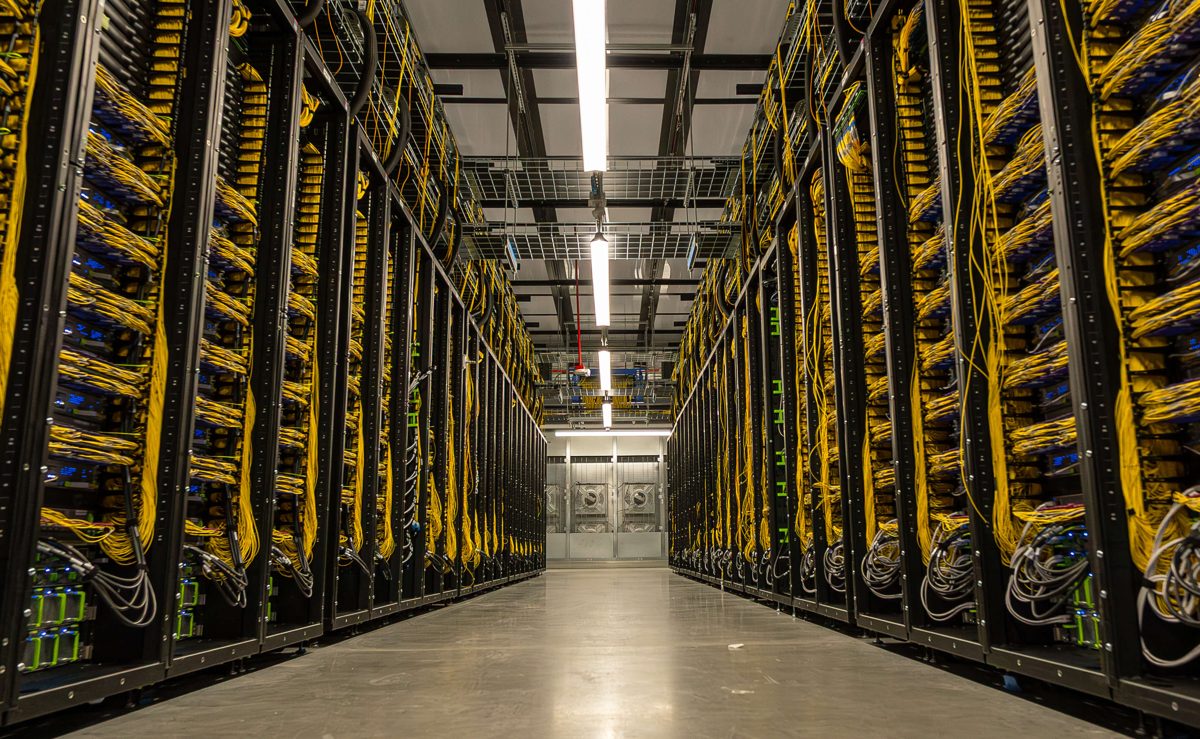
Meta חשפה את Prometheus, ה-supercluster בהיקף של גיגה-וואט שעליו היא מאמנת את משפחת המודלים Muse. לפי הבלוג ההנדסי של החברה, השלב הראשון הושלם, ו-Meta מרחיבה את המערכת לעבר כמיליון GPU. Prometheus הוא התשתית הפיזית שמאחורי Muse Wonder, Muse Spark Open ו-Muse Glimmer, שיצאו החודש.
הפוסט שם דגש על ההנדסה שנדרשת בסקייל כזה, ובעיקר על קירור נוזלי במעגל סגור. צפיפות ההספק לכל rack בדורות ה-GPU הנוכחיים כבר גבוהה ממה שקירור אוויר מסוגל להתמודד איתו, וצריכת המים הפכה לנושא פוליטי בכל דיון על מיקום דאטה-סנטר. מערכות במעגל סגור מחזירות את נוזל הקירור לסירקולציה, חוסכות במים ומאפשרות פריסה צפופה יותר. בהיקף של גיגה-וואט, אספקת חשמל, טופולוגיית רשת וטיפול בתקלות מכריעים לא פחות ממספר השבבים.
החשיפה משתלבת בנושא המרכזי של השבוע: כוח מחשוב והון. OpenAI מגייסת 30 מיליארד דולר במפורש להרחבת דאטה-סנטרים. Alibaba Cloud הציגה תוכנית בנייה של 20GW לשש שנים על שבבים פנימיים. MAI-Base-2 של Microsoft אומן בכמעט פי 100 מכוח המחשוב של ריצות ה-scaling שקדמו לו. הפרסום של Prometheus עוזר ל-Meta לטעון שהמקום שלה בין המודלים המובילים נשען על תשתית יציבה, ולא על ריצת אימון אחת שהצליחה במקרה.
המשקיעים יסתכלו בעיקר על העלות. ההוצאות ההוניות של Meta כבר הדאיגו את השוק לא פעם, והפוסט לא נותן סכומים או לוח זמנים להגעה למיליון GPU. גם מקורות האנרגיה וההשפעה על רשת החשמל המקומית נשארים בלי תשובה. כדאי לעקוב אחרי שיחת הרווחים הבאה של Meta, אחרי תחזית ה-capex לשלבים הבאים של Prometheus, ואחרי השאלה אם איכות מודלי Muse מצדיקה את ההשקעה בחומרה.