Hugging Face משיקה את Carbon-X: מודל פתוח של 14.8B שעונה על שאלות על DNA בשפה טבעית
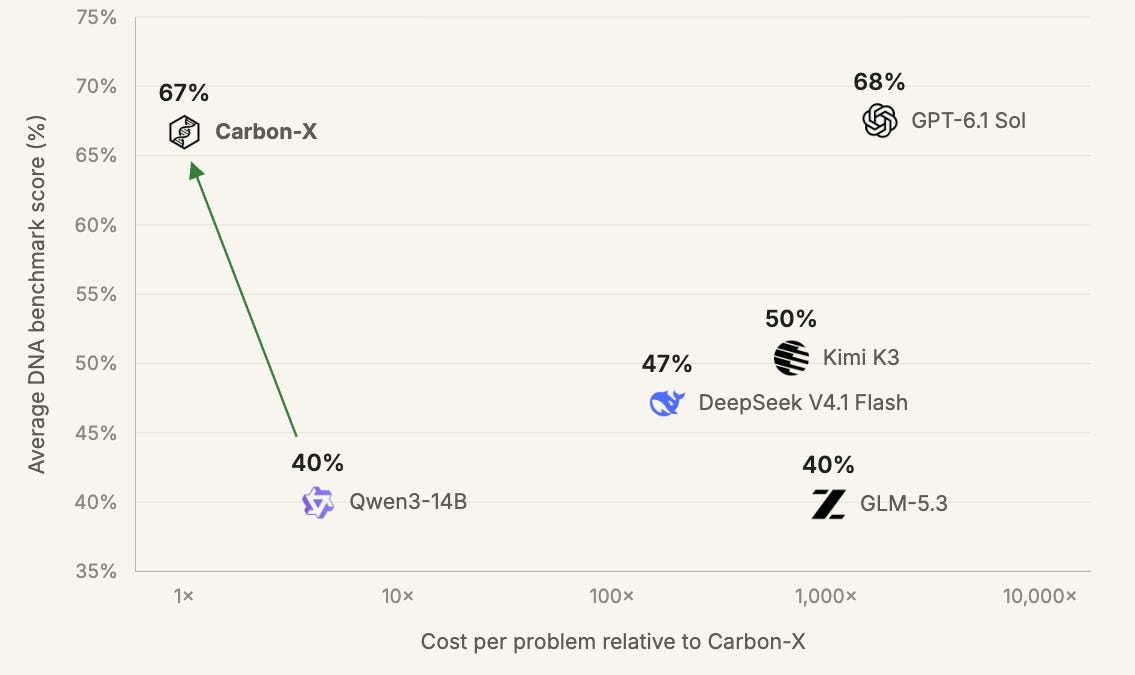
Carbon-X מאפשר לחוקרים לתשאל רצפים גנומיים בשפה טבעית ולשאול על תפקוד, וריאנטים או אלמנטים רגולטוריים, בלי pipelines ייעודיים של ביואינפורמטיקה. Hugging Face בנתה אותו על בסיס Qwen3-14B ואימנה אותו על נתונים גנומיים של בני אדם, יונקים, צמחים ופטריות, כך שהוא מכסה הרבה יותר מהמיקוד האנושי של רוב מודלי הביולוגיה.
הנתון הבולט הוא היעילות. בחמישה benchmarks של DNA, Carbon-X משיג ממוצע של 66.7%, לעומת 67.5% ל-GPT-6.1 Sol של OpenAI, בעלות של בערך אלפית. הוא רץ על GPU יחיד של 80GB, ולכן נגיש גם לקבוצות מחקר באוניברסיטאות שלא יכולות לשלוח מידע גנומי רגיש ל-API חיצוני.
ההשקה מתחברת לנושא שעלה בקהילה השבוע. שרשור ב-Hacker News (459 נקודות) הראה CNN בן עשר שמנצח את ה-LLMs המובילים באבחון סרטן עור, ומודלים קטנים וממוקדים ממשיכים להשתוות לכלליים או לעקוף אותם בתחומים צרים. Carbon-X מוסיף עוד ראיה לכך ש-post-training ייעודי על מודל פתוח יכול לסגור את רוב הפער.
במקביל Hugging Face נהנית ממומנטום רחב יותר: הרובוט Microduck עבר 20,000 הזמנות מוקדמות במחיר 399 דולר, והמנכ"ל Clem Delangue מגייס לכל צוותי Pollen Robotics. לגבי Carbon-X יש שתי הסתייגויות: רוחב ה-benchmarks והוולידציה. חמישה benchmarks הם עדשה צרה, וטעויות בפענוח גנומי עולות ביוקר, כך שרק ולידציה במעבדה רטובה ובקליניקה תקבע אם הוא יצא מגבולות המחקר הגישושי.