חדשות ה-AI של DeepSeek
כל כתבות ה-AI שפרסמנו על DeepSeek — 96 כתבות לאורך 18 אפר׳ 2026 – 17 ספט׳ 2026. עקבו אחר השקות המודלים, המחקר, המוצרים והשותפויות של DeepSeek בתעשיית ה-AI, בעדכון יומי.
96 כתבות · 18 אפר׳ 2026 – 17 ספט׳ 2026
DeepSeek משיקה את V4.1-Flash: 552 מיליארד פרמטרים, vision מובנה ו-output זול ב-60%
DeepSeek שחררה את V4.1-Flash, מודל mixture-of-experts עם 552 מיליארד פרמטרים (8B פעילים בקלט, 16B בפלט), חלון context של 1M tokens והבנה ויזואלית native. תמחור ה-API מוזיל עלויות בעד 60% לעומת V4-Pro, ב-0.30 דולר למיליון קלט ו-1.20 דולר למיליון פלט. מפתחים העלו במהירות forks 'abliterated' ללא צנזורה ל-Hugging Face.
2026-09-17
0.15 דולר למיליון tokens: DeepSeek משחררת את V4.1-Flash ברישיון MIT עם חלון של מיליון tokens
DeepSeek-V4.1-Flash הוא מודל MoE עם 552B פרמטרים ו-8B/16B פרמטרים פעילים, הבנה ויזואלית מובנית ו-context של מיליון tokens, ששוחרר תחת רישיון MIT ב-0.15 דולר למיליון tokens קלט ו-0.60 דולר למיליון tokens פלט. לפי הדיווחים הוא משתווה או עוקף את Claude Opus 5 ו-GPT-5.6 Sol ב-benchmarks של agents, תוך צמצום של 75% בדרישות ה-HBM ל-KV-cache. DeepSeek גם גייסה CFO לקראת IPO אפשרי בבורסת STAR בשנגחאי.
2026-09-16
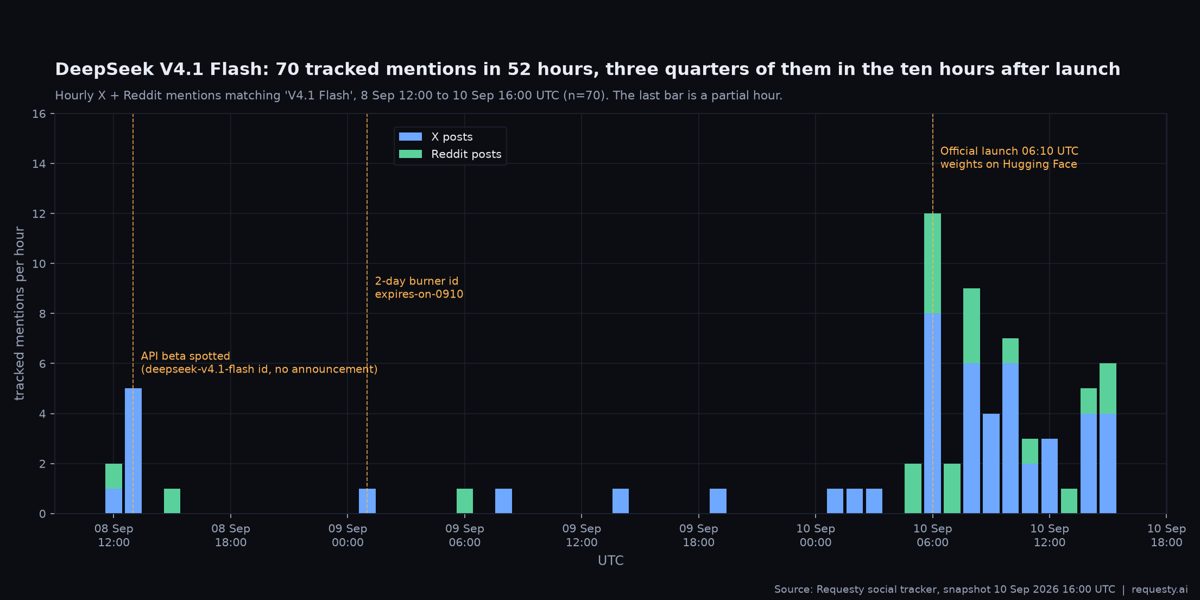
DeepSeek משיקה את V4.1 Flash עם vision — ואז מחזירה את V4 Pro
DeepSeek השיקה את V4.1 Flash, המודל הקטן ביותר במשפחת הארכיטקטורה החדשה שלה, במחיר 0.15/0.60 דולר למיליון token של קלט/פלט בשעות שאינן שיא, עם קלט תמונה נייטיבי. בתחילה תכננה להוציא משימוש את V4 Pro ב-14 בספטמבר ולנתב בקשות ל-Flash, אך היפכה את התוכנית בעקבות ביקוש מהמשתמשים, והשאירה את שני המודלים פעילים בתמחור ללא שינוי.
2026-09-14
DeepSeek משיקה את V4.1-Flash: encoder-decoder סיבתי, context של מיליון tokens ו-vision
DeepSeek השיקה את V4.1-Flash, מודל Mixture-of-Experts פתוח בגודל 763 מיליארד פרמטרים עם ארכיטקטורת causal encoder-decoder חדשה, ראייה מולטימודלית מובנית, חלון context של מיליון token ומהירויות של מעל 400 token לשנייה. למרות שהוא גדול פי 2.5 מהמודל שהוא מחליף, שינויים ארכיטקטוניים חתכו את צריכת ה-KV-cache ל-13% עד 25% מזו של DeepSeek V4 Flash. תמחור מחוץ לשעות העומס הוא 0.15 דולר למיליון token קלט ו-0.60 דולר למיליון token פלט; V4 Pro יורד מהמדף ב-14 בספטמבר.
2026-09-13
DeepSeek משיקה את V4.1-Flash עם context של מיליון tokens — ונערכת ל-IPO של 75 מיליארד דולר בשנגחאי
DeepSeek שחררה את V4.1-Flash, מודל MoE רזה עם ראייה מולטימודלית מובנית, חלון context של מיליון tokens ומעל 400 tokens לשנייה, שמפעיל רק כ-8B מתוך 552B פרמטרים ומשתמש ב-890 בייטים בלבד של KV cache לכל token. DeepSeek טוענת שהוא עוקף את הדגל V4-Pro במשימות coding ואג'נטיות במחיר אגרסיבי, והיא שכרה את CITIC Securities לקראת IPO ב-STAR Market בשווי של כ-75 מיליארד דולר.
2026-09-12
DeepSeek משיקה בטא של V4.1 Flash: multimodal מובנה וקיצוץ 60% במחיר המטמון
DeepSeek פתחה beta מוגבל של V4.1 Flash (8–10 בספטמבר) עם תמיכה multimodal מובנית, יכולת גבוהה יותר ו-decoding מהיר יותר של 333–400+ token לשנייה. היא מחליפה לצמיתות את V4 Pro, עם קיצוץ של 60% במחיר input שנשמר במטמון ל-0.003 דולר למיליון token מחוץ לשעות העומס. בנפרד, DeepSeek בחרה ב-CITIC Securities ל-IPO בבורסת STAR של שנחאי שמכוונת לפי הדיווחים לשווי של 75 מיליארד דולר.
2026-09-10
DeepSeek V4.1 Flash בבטא: multimodal ב-333-400+ tok/s
DeepSeek השיקה ב-8 בספטמבר את הבטא של V4.1 Flash עם תמיכה מולטימודלית מקורית, מהירות decode של 333–400+ tokens לשנייה וחלון context של מיליון tokens, במחיר דומה ל-V4-Flash, עם הוזלת מחיר של 60% ב-cache-hit שנכנסת לתוקף ב-10 בספטמבר. השחרור מגיע בזמן ש-DeepSeek חותרת לעצמאות בשבבים, ולפי הדיווחים תכננה לפחות 160,000 מאיצי Huawei Ascend 950DT ל-data center בסדר גודל של גיגה-וואט במונגוליה הפנימית. החברה מגייסת 150 מהנדסי backend בכירים כדי להרחיב את התשתית.
2026-09-09
DeepSeek V4-Pro שומר על תמחור $0.87 בזמן ש-SWE-bench Verified מטפס ל-80.6%
DeepSeek שחררה את גרסת הייצור של V4-Pro (גרסה פנימית 0813) באוגוסט, ויצאה מ-preview. החברה השאירה את מחיר הפלט של V4-Pro על 0.87$ למיליון tokens גם כשציון ה-SWE-bench Verified שלו טיפס ל-80.6%, לפי ה-changelog של ה-API. שחרור נלווה של V4-Flash ליווה את ההשקה, וממצב אותו מול Claude Opus 5 ו-Gemini 3.1.
2026-09-08
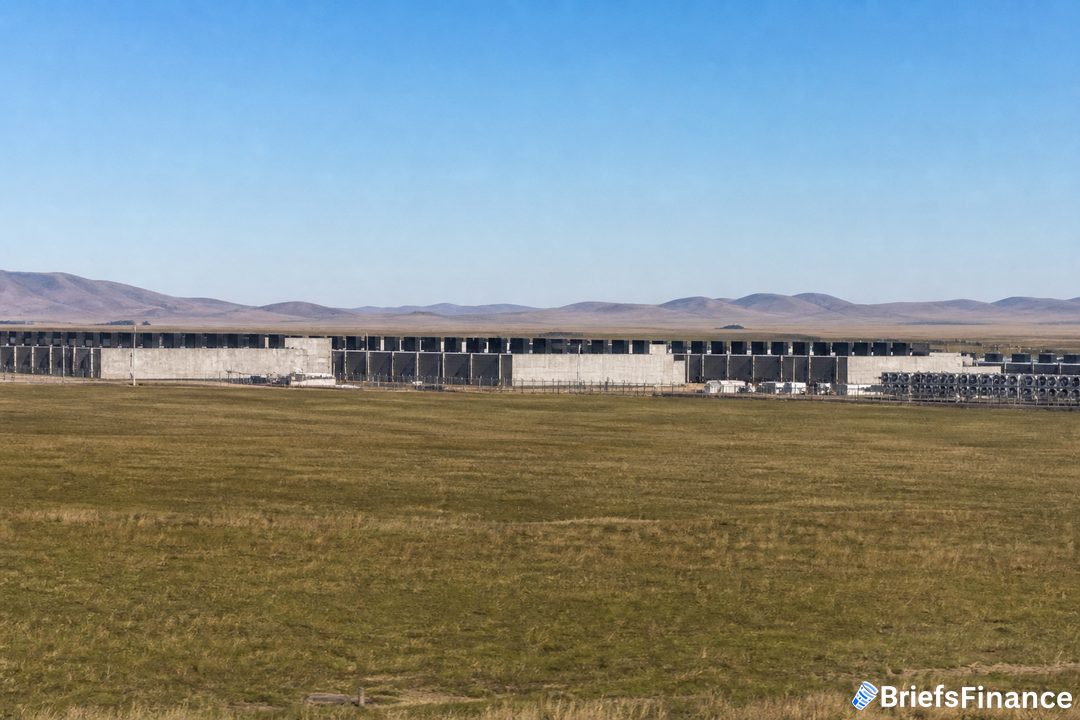
DeepSeek מתכננת מרכז נתונים עם 160,000 שבבי Huawei במונגוליה הפנימית
DeepSeek מתכננת data center חדש ל-AI במונגוליה הפנימית שיופעל על ידי 160,000 שבבים של Huawei, ותישען על מעבדי ה-Ascend של Huawei כאלופת המחשוב המקומית של סין. הבנייה מדגישה את הדחיפה של סין לעצמאות בחומרה על רקע הגבלות היצוא של ארה"ב, בעוד Huawei שואפת לייצר כ-1.6 מיליון dies של Ascend ב-2026.
2026-09-07
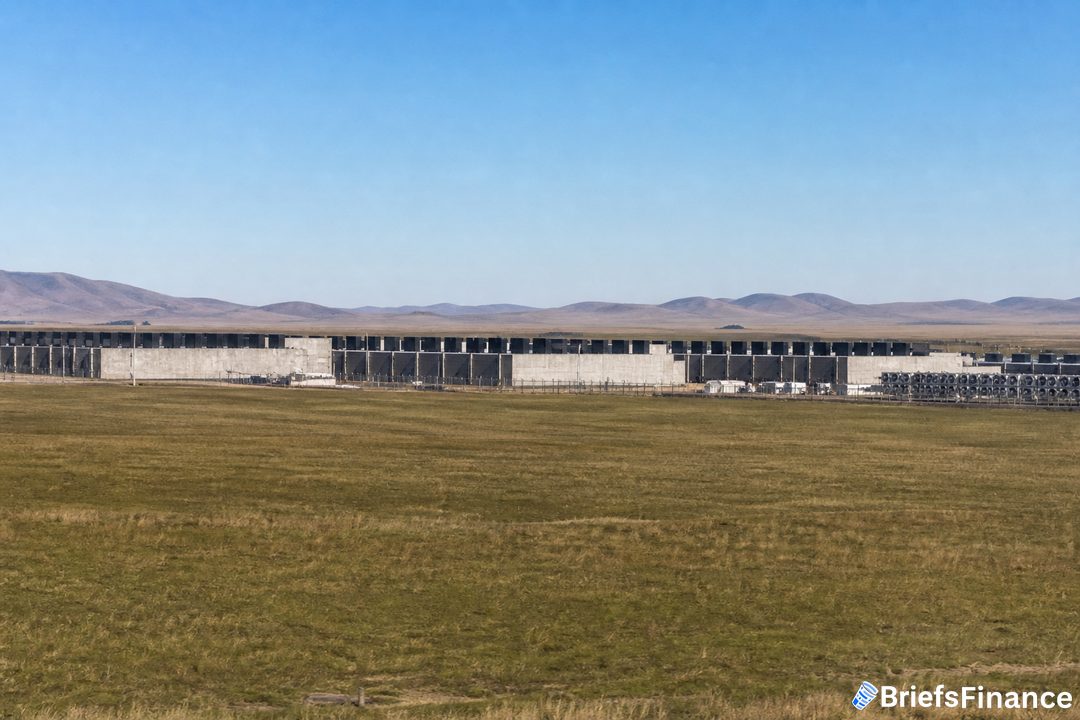
DeepSeek מזמינה 160,000 שבבי Huawei למרכז נתונים במונגוליה הפנימית
DeepSeek נערכת להזמין לפחות 160 אלף מאיצי AI מסוג Huawei Ascend עבור data center חדש במונגוליה הפנימית, ומעמיקה את אסטרטגיית כוח המחשוב המקומי של סין. מודלי V4 שלה — V4-Pro (1.6T פרמטרים, 49B פעילים) ו-V4-Flash (284B סה"כ, 13B פעילים) — כוללים context window של מיליון token, כאשר V4-Pro-Max מגיע ל-80.6% ב-SWE-bench Verified.
2026-09-06
ארגונים עוברים למודלים הזולים של DeepSeek — גם כשמחירי ה-API מזנקים
לפי הדיווחים, ארגונים כמו AT&T מנתבים עומסים למודלים הזולים יותר של DeepSeek, ומחליפים את Claude ואת GPT כדי לחסוך בעלויות. במקביל, DeepSeek מעלה את מחירי ה-API של מודלי V4-Flash ו-V4-Pro בעד 1,100%, כשחברת ה-AI הסינית דוחפת לרווחיות לקראת IPO מתוכנן — מה שמצמצם אך לא מוחק את יתרון העלות שלה.
2026-09-05

DeepSeek פותחת ל-open-source את מודל הראייה הראשון שלה מסדרת V4 תחת רישיון MIT
DeepSeek פרסמה ב-31 באוגוסט מודל פתוח בשם V4-Flash-Vision-Exp, והוסיפה לראשונה יכולת reasoning על תמונות למשפחת V4. המודל, sparse Mixture-of-Experts עם 305 מיליארד פרמטרים, זמין להורדה חופשית תחת רישיון MIT — ומתואר כראשון מסוגו שמפתח יכול פשוט להשיג.
2026-09-03
DeepSeek מעלה את V4-Flash-Vision-Exp — מודל vision פתוח — ל-Hugging Face
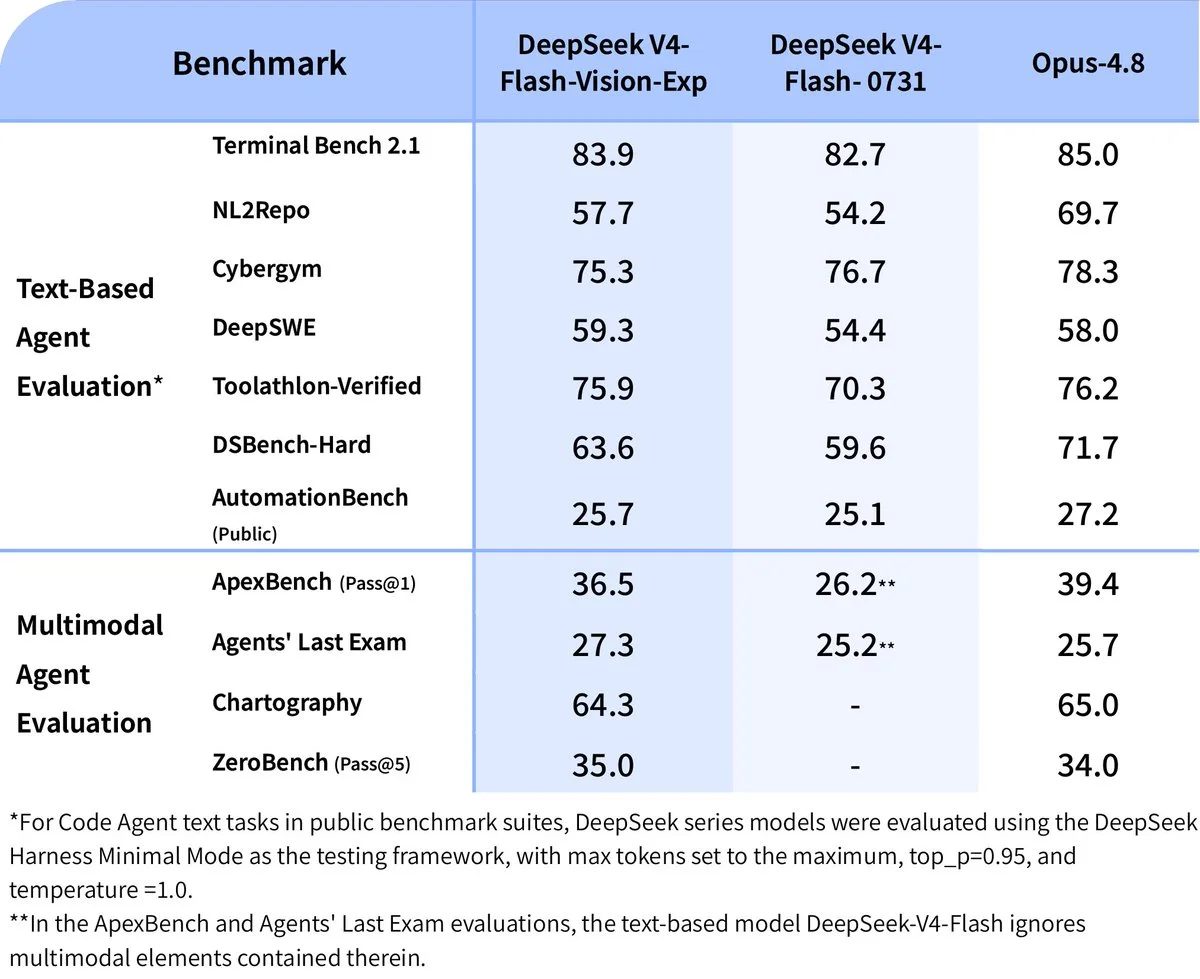
DeepSeek שחררה בשקט את DeepSeek-V4-Flash-Vision-Exp, מודל מולטימודלי ניסיוני להבנת ראייה, ב-Hugging Face ובפלטפורמת ה-API שלה, והציתה התלהבות ב-r/LocalLLaMA (641 upvotes). המודל מקרב יכולות agent מולטימודליות לרמת Opus-4.8 תוך שמירה על ביצועי טקסט טהור ברמת ה-V4-Flash הרגיל.
2026-09-02
DeepSeek V4-Flash חותכת מחירים ל-0.14 דולר למיליון tokens בזמן ש-Harness מתקרב ל-200 אלף כוכבים
V4-Flash של DeepSeek מתחרה אגרסיבית במחיר של 0.14 דולר למיליון input tokens ו-0.28 דולר למיליון output עם context של מיליון tokens, מול Gemini 3.7 Flash ו-Qwen3.8 Flash. ה-DeepSeek Harness צבר כמעט 200,000 כוכבים ב-GitHub, ו-Modellix.ai של Aurora Mobile הוסיף מודלי DeepSeek חינמיים דרך plugin ב-beta.
2026-09-01
DeepSeek משיקה את Harness — agent runtime מודולרי בקוד פתוח
DeepSeek שחררה את Harness (dsh), agent runtime בקוד פתוח תחת רישיון MIT שבנוי על ההנחה ש'agent של AI שווה למודל ועוד ה-harness שלו'. הארכיטקטורה מרכיבה שירותי runtime — לולאת ה-agent, אחסון sessions, הרשאות — כ-plugins שניתן להחליף על גבי framework בשם Cordis, עם עדכון מ-20 באוגוסט שמשפר את ה-pipeline המולטימודלי שלה לקלט תמונות.
2026-08-30
DeepSeek משחררת את Harness: מנהל workflow מקומי ל-AI בקוד פתוח
DeepSeek הציגה את DeepSeek Harness, תוכנה open-source שרצה מקומית לניהול workflows של AI, זמינה כתצוגה מקדימה למפתחים. היא מציעה ממשק web גרפי לשליטה ישירה על workflows במכונות מקומיות, ומתעדפת פרטיות, שליטה וחיסכון בעלויות על פני frameworks מבוססי ענן, עם התאמה מודולרית של plugins ותמיכה במספר ספקים.
2026-08-27
DeepSeek חושפת את V4-Flash עם ראייה — וטוענת שהוא משתווה לצמרת של Anthropic
DeepSeek הסינית הציגה את DeepSeek-V4-Flash-Vision-Exp, גרסה multimodal ניסיונית שלטענתה מתחרה מקרוב ב-Opus 4.8 של Anthropic בהערכות agentic multimodal. היא זמינה דרך ה-API של DeepSeek, ומעבדת, מעריכה ומבצעת משימות מקלט חזותי תוך שמירה על ביצועי ה-benchmark החזקים של V4-Flash בטקסט.
2026-08-25
DeepSeek רודפת אחרי Opus 4.8: V4-Flash-Vision-Exp על רקע IPO של 86 מיליארד דולר
DeepSeek שחררה מודל multimodal ניסיוני, DeepSeek-V4-Flash-Vision-Exp, שמרחיב את פלטפורמת V4 Flash לעיבוד תמונות וצילומי מסך. החברה טוענת לביצועים כמעט זהים ל-Opus 4.8 של Anthropic במשימות agent חזותיות. המודל תומך ב-JPEG, PNG, GIF ו-WebP, עד 600 תמונות בבקשה, ומגיע עם DeepSeek Harness מעודכן — כל זאת על רקע ספקולציות על IPO בשווי כ-86 מיליארד דולר.
2026-08-24
DeepSeek משיקה V4-Flash-Vision — מודל multimodal ניסיוני על רקע קדחת IPO של 86 מיליארד דולר
DeepSeek השיקה את DeepSeek-V4-Flash-Vision-Exp, מודל multimodal ניסיוני שמנתח תמונות, צילומי מסך ו-prompts ויזואליים תוך שמירה על יכולות טקסט, reasoning ו-agent. לפי הדיווחים הוא מתקרב ל-Opus של Anthropic במשימות agent מסוג multimodal, וזאת על רקע שמועות על IPO בשווי 86 מיליארד דולר.
2026-08-23
DeepSeek מעלה את V4-Pro ל-GA במחיר גבוה פי 14 — והמשתמשים זועמים
DeepSeek הכריזה על זמינות כללית של מודל הדגל שלה DeepSeek-V4-Pro-0813, מודל mixture-of-experts בגודל 1.6 טריליון פרמטרים עם חלון context של מיליון token, בתמחור גבוה פי 14 בערך מהמודל הזול ביותר שלה. ה-GA מוסיף שליטה גמישה במאמץ ה-thinking ותמחור API לפי שעות שיא/שפל — סטייה חדה מהמוניטין הזול של DeepSeek שעוררה תלונות משתמשים.
2026-08-21

DeepSeek משיקה את V4 Pro בגודל 1.7 טריליון — ומייקרת את ה-API עד 1,100%
DeepSeek השיקה את DeepSeek-V4-Pro-0813, מודל MoE של 1.7 טריליון פרמטרים (49B פעילים לכל token) עם context של מיליון tokens, שקיבל ציון 87.9 ב-Terminal Bench 2.1. במקביל היא שחררה את DeepSeek Harness v0.1, מסגרת agent ברישיון MIT שמתחרה ב-Claude Code. אבל ההשקה נוטשת את המוניטין הזול של DeepSeek: החברה עברה לתמחור שיא/שפל שמייקר את עלויות ה-API ב-50%-1,100%, כש-V4 Pro מתומחר פי 14 מהמודל הזול ביותר שלה.
2026-08-20

DeepSeek-V4-Pro ב-GA: 1.6T פרמטרים — ו-surge pricing ששובר עצבים
DeepSeek העבירה את V4-Pro (build 0813) מ-preview של ארבעה חודשים לזמינות כללית, עם 1.6T פרמטרים כוללים (49B פעילים), חלון context של מיליון tokens ושיפור ב-benchmarks של agents (87.9 ב-Terminal Bench 2.1, 62.7 ב-DeepSWE). החל מ-16 באוגוסט היא הנהיגה תמחור מדורג לפי עומס, שבו התעריפים בשעות השיא מכפילים פי ארבע — output של עד 3.96 דולר למיליון — היפוך מהבטחות קודמות שעורר ביקורת חריפה מצד מפתחים.
2026-08-18
DeepSeek משיקה את V4-Pro-0813 עם יכולות agent — ומיד מקפיצה מחירים פי 4 עד 14
DeepSeek השיקה רשמית את V4-Pro-0813 באפליקציה, בווב וב-API, עם יכולות agent משופרות, חלון context של מיליון token ורמת reasoning מתכווננת — אבל במקביל העלתה מחירים בחדות, החל מ-16:00 UTC ב-16 באוגוסט. בשעות העומס מחיר ה-output של V4-Pro קופץ מ-0.87 ל-3.96 דולר למיליון token (בערך פי 4.5, ומחיר ה-cache עולה עד פי 10), בעוד שמחוץ לשעות העומס יש הנחה של 50%. בתעשייה קוראים את המהלך כשבירה הגדולה הראשונה של מלחמות המחירים ב-AI, וכסימן לכך שמחסור בכוח מחשוב הפך לאילוץ מחייב.
2026-08-16

1.6 טריליון פרמטרים ושווי 74 מיליארד: DeepSeek משיקה את V4 Pro לזמינות מלאה
DeepSeek שחררה את DeepSeek-V4-Pro-0813 לזמינות כללית ב-12 באוגוסט, והוציאה את מודל הדגל שלה — mixture-of-experts בגודל 1.6 טריליון פרמטרים — מ-preview שנמשך כמעט ארבעה חודשים. התמחור נשאר ברמות ה-preview: $0.435 למיליון token קלט, $0.003625 למיליון ב-cache hit, ו-$0.87 למיליון token פלט בתוך חלון הקשר של מיליון token. החברה השלימה סבב גיוס לפי שווי של 500 מיליארד יואן (74 מיליארד דולר), עלייה של 40% מיוני, ומקימה צוות שיכוון לשוק ה-agentic-coding.
2026-08-13

DeepSeek מזהירה מעליית מחירי API אחרי שעיבדה 8 טריליון tokens ביום אחד
DeepSeek הודיעה ללקוחות ה-API על העלאות מחיר משמעותיות בכל השירותים, במהלך שהופך את אסטרטגיית הוזלת המחירים שלה, אחרי ש-V4-Flash עיבד 8 טריליון token ביום אחד וחרג מקיבולת ה-GPU. היא גם חידשה סבב גיוס של 8 מיליארד דולר בשווי של כ-74 מיליארד דולר, ורכשה נתח של 2.31% ביצרנית הרובוטים ההומנואידיים Unitree לקראת ה-IPO שלה.
2026-08-11

DeepSeek מזהירה מהעלאת מחירים 'משמעותית' ופותחת סבב 8 מיליארד דולר בשווי 74 מיליארד
DeepSeek הודיעה למשתמשים על העלאות מחיר 'משמעותיות' קרובות ב-API בכל השירותים, במהלך שהופך את התמחור הנמוך במיוחד שהצית קריסת מחירי AI גלובלית; התעריפים הנוכחיים ל-V4-Flash הם 0.14 דולר למיליון input ו-0.28 דולר למיליון output. החברה פתחה מחדש סבב גיוס שמבקש כמעט 8 מיליארד דולר בשווי של כ-74 מיליארד דולר, ורכשה נתח של 2.31% (20.8 מיליון דולר) בחברת הרובוטיקה Unitree.
2026-08-10

'עידן ה-AI הזול נגמר': DeepSeek מאותתת על העלאת מחירי API — ומחדשת סבב של 8 מיליארד דולר לפי 74 מיליארד
DeepSeek פרסמה הודעה שמזהירה מהעלאת מחירים 'משמעותית' צפויה ב-API בכל השירותים, במהלך שהופך את אסטרטגיית חיתוך המחירים האגרסיבית שלה על רקע ביקוש עולמי מתגבר למודלים הזולים שלה. החברה גם חידשה סבב גיוס שני שמחפש כ-8 מיליארד דולר בשווי של כ-74 מיליארד דולר, כשמנוהל Monolith Management נמצא במגעים, ורכשה 2.31% מיצרנית הרובוטים Unitree.
2026-08-09

סוף למלחמת המחירים: DeepSeek מעלה מחירי API אחרי 8 טריליון tokens ביום
DeepSeek הכריזה על העלאת מחיר 'משמעותית' ב-API בכל השירותים, ובכך הפכה את הכיוון מהתפקיד שלה כמי שהציתה את מלחמת המחירים הגלובלית, אחרי שהביקוש למודל V4-Flash הזול-במיוחד שלה זינק — 8 טריליון token עובדו ב-1 באוגוסט לבדו. התמחור של V4-Flash, שעומד על 0.14$ למיליון token בקלט ו-0.28$ בפלט, יעלה משמעותית. DeepSeek גם חידשה סבב גיוס של 8 מיליארד דולר לפי שווי של כ-74 מיליארד דולר.
2026-08-08
DeepSeek מזהירה: מחירי API עולים פי 2 עד פי 10 — וגיוס של 8 מיליארד בשווי חצי טריליון
DeepSeek הכריזה על העלאת מחירי API 'משמעותית' לרוחב כל הקו, כשהמייסד Jun Song מאותת על העלאות אפשריות של פי 2 עד פי 10 אך מתחייב להישאר מתחת למתחרים המערביים, בהתייחסו לביקוש עולמי מרקיע שחקים למודלים הזולים במיוחד שלה. V4-Flash עולה כרגע $0.14 למיליון input tokens (cache miss) ו-$0.28 ל-output, והוביל את השימוש השבועי ב-OpenRouter עם 7.22 טריליון token. החברה גם חידשה סבב גיוס שמחפש 8 מיליארד דולר בשווי של 500 מיליארד דולר לפני ההשקעה.
2026-08-07
המודל הפתוח V4-Flash של DeepSeek נוחת ב-0.03$ למשימה — פי 105 זול מ-Claude Fable 5
DeepSeek השיקה את המודל הפתוח V4-Flash במחיר של 0.14$ לקלט ו-0.28$ לפלט למיליון tokens — כ-0.03$ למשימת benchmark, זול פי 105 בערך מ-Claude Fable 5 של Anthropic שעומד על 3.15$. V4-Flash מקבל ציון 50 במדד האינטליגנציה של Artificial Analysis, בדיוק כמו Gemini 3.6 Flash של Google, ומוסיף יכולות agent משופרות. חברת מחקר קבעה שזה המודל הזול ביותר להרצה מבין המודלים המוכרים בעולם.
2026-08-06

28 סנט למיליון tokens: DeepSeek V4-Flash זורק את המחירים לרצפה וכובש את השימוש הגלובלי
DeepSeek השיקה את V4-Flash במחיר 0.14$ למיליון token קלט ו-0.28$ למיליון token פלט — מה שחברת מחקר מצאה שזול פי 100 להרצה מ-Claude Fable 5 של Anthropic, וקובע benchmark חדש של עלות נמוכה בתעשייה. עד ה-4 באוגוסט, V4-Flash הוביל בשימוש ה-token העולמי עם 7.1 טריליון token בשבוע, כשתשעה מתוך עשרת המודלים המובילים הם כעת סיניים.
2026-08-05

0.14 דולר למיליון tokens: DeepSeek V4-Flash זול פי 100 מ-Claude Fable 5
DeepSeek שחררה רשמית את V4-Flash-0731, מודל של 284 מיליארד פרמטרים במחיר של 0.14$ למיליון tokens בקלט ו-0.28$ בפלט — זול פי 100 ויותר מ-Claude Fable 5 של Anthropic. למרות גודלו הקטן יותר הוא עולה ב-14% על V4-Pro של DeepSeek בן 1.6 טריליון הפרמטרים בטבלאות האינטליגנציה, רץ בכ-142GB ב-FP4, וקיבל ציון 82.7 ב-Terminal Bench 2.1. ה-API שלו נכנס ל-public beta ב-31 ביולי.
2026-08-04

DeepSeek מציתה מלחמת מחירים: V4-Flash-0731 מנצח את V4-Pro ב-0.14 דולר למיליון token
DeepSeek השיקה רשמית את V4-Flash-0731, מודל MoE עם 284B פרמטרים כוללים / 13B פעילים, במחיר של 0.14$/0.28$ למיליון tokens ועם context של מיליון tokens. הודות לשיפורי post-training הוא רשם 82.7% ב-Terminal-Bench 2.1 (עלייה מ-61.8%), עקף את 72.1% של V4-Pro-Preview והשתווה ל-Gemini 3.6 Flash — מהלך משמעותי במלחמת מחירי ה-inference, שלדברי מפתחים זול פי 18 עד 28 מ-Claude.
2026-08-03

DeepSeek משחררת את V4-Flash-0731 ומאיצה את ה-"race to zero" של AI
DeepSeek השיקה את V4-Flash-0731, מודל MoE בגודל 284B/13B שקלע 82.7% ב-Terminal-Bench ו-50 ב-ArtificialAnalysis Index — נקודה אחת בלבד מתחת ל-GLM-5.2 ו-GPT-5.6 Luna — במחירי flash של כ-0.14$ למיליון input ו-0.28$ למיליון output. הוא תומך ב-Responses API של OpenAI ובפורמט ההודעות התואם-Claude של Anthropic, ו-r/LocalLLaMA כבר מכנה אותו טלטלה נוספת בשוק.
2026-08-02

DeepSeek משלימה מעבר ל-V4: context של מיליון tokens, פי 50 יותר זול
DeepSeek הוציאה משימוש את המזהים הישנים deepseek-chat ו-deepseek-reasoner ב-24 ביולי, ועברה במלואה ל-V4 Pro (1.6 טריליון פרמטרים, 49 מיליארד פעילים) ול-V4 Flash (284 מיליארד), ששניהם מציעים חלונות הקשר של מיליון tokens ותמחור שחותך את Anthropic בפי 50 בערך ל-token. המעבר האגרסיבי מאיץ את אימוץ המודלים הפתוחים. בנפרד, DeepSeek עצרה סבב גיוס שני אחרי שתדריך משקיעים חסוי של המייסד Liang Wenfeng דלף לרשת.
2026-07-31
DeepSeek מתכננת data center של גיגה-וואט במונגוליה הפנימית
DeepSeek הכריזה על תוכניות לבנות מרכז נתונים עצום להספק גיגה-וואט ב-Ulanqab שבמונגוליה הפנימית, אולי תוך שימוש במעבדי Blackwell של NVIDIA. הבנייה מסמנת התרחבות תשתית אגרסיבית ומקדימה שמועות על IPO, בעקבות סבב מימון מדווח של 7 מיליארד דולר שמעריך את החברה בקרוב ל-50 מיליארד דולר.
2026-07-31

DeepSeek פורשת משמות המודלים הישנים לטובת V4 ועוצרת סבב גיוס של 74 מיליארד דולר
DeepSeek הוציאה משירות ב-24 ביולי את ה-aliases הישנים deepseek-chat ו-deepseek-reasoner ב-API, והעבירה את כל התעבורה ל-V4 Pro (1.6 טריליון פרמטרים, 49 מיליארד פעילים) ול-V4 Flash (284 מיליארד), ששניהם מציעים context בן מיליון tokens תחת רישיון MIT. היא גם השהתה גיוס Series B בהיקף 74 מיליארד דולר לאחר שהערות שדלפו מהמייסד על נחיתות כוח המחשוב של סין והתלות ב-Nvidia הפכו לויראליות.
2026-07-30

DeepSeek V4 יוצא ל-GA, מוציא לגמלאות aliases ישנים ומוסיף surge pricing
DeepSeek הכריזה על זמינות כללית של משפחת מודלי V4, וגמלה את הכינויים הישנים `deepseek-chat` ו-`deepseek-reasoner` (שמפנים כעת ל-`deepseek-v4-flash` או `deepseek-v4-pro`), ואישרה תמחור surge לפי שעות היום שמגיע בקרוב. V4 Flash מכוון למהירות ויעילות עלות בצ'אט ובסיווג, בעוד V4 Pro מטפל ב-reasoning מורכב ובמשימות long-context עד מיליון tokens.
2026-07-27

מייסד DeepSeek בוחר AGI על פני רווח — באמצע גיוס של 71-74 מיליארד דולר
DeepSeek מגייסת סבב חדש לפי שווי יעד של $71-74 מיליארד (עלייה מ-$50B ביוני) ומתכוננת ל-IPO אפשרי בשוק STAR של שנגחאי בסוף 2026. המייסד Liang Wenfeng אמר שהחברה תעדיף AGI לטווח ארוך על פני רווח וקרוב לוודאי תשמור את המודלים המתקדמים ביותר שלה open-source. DeepSeek גם בונה שבב inference ייעודי שמטרתו לחצות את ה-latency, וקרובה להשקה מלאה של מודל V4.
2026-07-26

DeepSeek מגייסת לפי 74 מיליארד דולר: 'AGI לפני רווח, והמודלים נשארים open-source'
DeepSeek מגייסת הון חדש לפי שווי של כ-74 מיליארד דולר (עלייה מ-50 מיליארד ביוני), ומכוונת לגייס עד 50 מיליארד יואן לקראת הגשת בקשה אפשרית ל-IPO בבורסת STAR Market בשנגחאי עוד השנה. המייסד Liang Wenfeng אמר שהחברה מתעדפת AGI לטווח ארוך על פני רווח, וסביר שתשמור את המודלים המתקדמים ביותר שלה open-source, בטענה שפיתוח פתוח ומונטיזציה אינם סותרים. תאריך יעד נוקשה של 24 ביולי מוציא משימוש את מזהי המודלים הישנים deepseek-chat ו-deepseek-reasoner.
2026-07-24
המודלים הפתוחים הסינים Kimi K3 ו-DeepSeek מציתים 'רגע ספוטניק' נוסף
המודל הפתוח Kimi K3 של Moonshot AI מתחרה במערכות של OpenAI ו-Anthropic בשבריר מהעלות, מה שאילץ את Moonshot להשעות מנויים חדשים על רקע ביקוש עצום ומחדד מחדש את הדיון על עלייתו של ה-AI הסיני. הסיקור מיסגר זאת כעוד 'רגע Sputnik', בעוד סין שוקלת לפי דיווחים להדק את בקרות הייצוא על מודלים, שבבים ומודלים פתוחים של חברות כמו Alibaba ו-ByteDance.
2026-07-24

DeepSeek V4 יוצא לכולם: חלון מיליון tokens ותמחור שמזנק בשעות העומס
DeepSeek V4 עברה מתצוגה מקדימה לזמינות כללית עם חלון context של מיליון token כסטנדרט בכל הרמות, לצד שיפורים בביצוע agent, בהיסק מתמטי ובכתיבת קוד. זו הופכת ל-API הראשון ברמה המובילה שמפורמל תמחור surge לשעות שיא/שפל, ומכפיל את המחירים בשעות העבודה בבייג'ין. הכינויים הישנים deepseek-chat ו-deepseek-reasoner יורדים ב-24 ביולי בשעה 15:59 UTC ללא תקופת חסד, ומכריחים מפתחים לעבור ל-deepseek-v4-flash או deepseek-v4-pro.
2026-07-23

DeepSeek V4 זמין לכולם — Flash של 284 מיליארד רץ מקומית ומתחרה ב-GPT-5.6 Sol בקוד
משפחת המודלים V4 של DeepSeek עברה מתצוגה מקדימה לזמינות מלאה, ושוחררה תחת רישיון MIT בשני גדלים: V4 Pro עם 1.6 טריליון פרמטרים ו-V4 Flash עם 284 מיליארד. בזכות ארכיטקטורת mixture-of-experts שמפעילה רק כ-13 מיליארד פרמטרים בכל רגע, המודל הקטן רץ מקומית ובכל זאת מתחרה במודלים המובילים בענן. בדיקות ראשוניות ממקמות את V4 קרוב ל-Opus של Anthropic ול-GPT-5.6 Sol במשימות קוד, בעלות נמוכה בהרבה. DeepSeek מתכננת IPO לפי שווי של 74 מיליארד דולר ב-2027.
2026-07-21

DeepSeek במגעים לגייס 1.5 מיליארד דולר, שוקלת IPO — ובונה שבב inference משלה
החברה הסינית DeepSeek מנהלת לפי הדיווחים מגעים עם משקיעים חדשים לגיוס של כ-1.5 מיליארד דולר, ועשויה להגיש IPO כבר השנה בשווי שמתקרב ל-69 מיליארד דולר ומעלה — אחרי סבב ראשון שגייס כ-7 מיליארד דולר. במקביל היא מפתחת שבב inference משלה כדי לצמצם את התלות ב-Nvidia וב-Huawei, כשגרסת DeepSeek-V4 היציבה יוצאת ב-17 ביולי ומזהי המודלים הישנים ייעלמו ב-24 ביולי.
2026-07-15

DeepSeek בונה chip inference ומגייסת 7 מיליארד דולר; מחירי V4 Flash נשארים בתחתית
DeepSeek מפתחת שבב AI ממוקד inference ומחפשת שותפי foundry וזיכרון כדי להפחית תלות ב-NVIDIA וב-Huawei על רקע מגבלות הייצוא האמריקאיות, במקביל לגיוס של 7 מיליארד דולר לפי שווי של 52-59 מיליארד דולר. שמות ה-API הישנים deepseek-chat ו-deepseek-reasoner ייפסקו ב-24 ביולי; תמחור V4 Flash של 0.09 דולר input ו-0.18 דולר output למיליון tokens נשאר נמוך בסדר גודל מ-GPT-5.6, כש-V4 צפוי באמצע יולי.
2026-07-14

DeepSeek משיקה V4 באמצע July — אחרי גיוס של 7.4 מיליארד דולר וקדחת תמחור
DeepSeek הכריזה על השקה באמצע יולי של V4 (1.6T פרמטרים, 49B פעילים) ושל V4-Flash (284B/13B פעילים), שניהם עם context של מיליון token באמצעות DSA sparse attention, לצד תמחור בשעות שיא בכפול מהמחיר בשעות רגילות. החברה סגרה סבב חיצוני ראשון של 7.4 מיליארד דולר בשווי של יותר מ-50 מיליארד דולר; שמות המודלים הישנים ייצאו משימוש ב-24 ביולי 2026.
2026-07-07

DeepSeek משחררת את DSpark בקוד פתוח להאצת V4; השקה באמצע יולי וגיוס של 7.4 מיליארד דולר
DeepSeek השיקה את DSpark, טכנולוגיה open-source שמאיצה משמעותית את ה-deploy של מודלי V4 שלה, שמשתמשים בארכיטקטורת MoE וחלון קונטקסט של מיליון tokens. V4 ישוחרר רשמית באמצע יולי עם תמחור לפי שעות היום שמכפיל את התעריפים בשעות השיא, והחברה סגרה סבב של 7.4 מיליארד דולר בשווי של יותר מ-50 מיליארד דולר בהובלת CATL, Tencent, NetEase ו-JD.com. המזהים הישנים deepseek-chat ו-deepseek-reasoner יופסקו ב-24 ביולי.
2026-07-06
הגרסה המקדימה של DeepSeek-V4 מתמחרת פי 10 מתחת למתחרים — שמות ה-API הישנים נעלמים ב-July 24
DeepSeek-V4 עדיין ב-preview, עם V4-Pro (1.6T פרמטרים, 49B מופעלים) ו-V4-Flash (284B פרמטרים, 13B מופעלים), ששניהם תומכים בחלון הקשר של מיליון token דרך DSA sparse attention. V4-Flash עולה 0.28 דולר למיליון output token — בערך פי 10 זול יותר מהמודלים המובילים במערב — והשמות הישנים deepseek-chat ו-deepseek-reasoner יוצאו משימוש ב-24 ביולי, כשהשקה מלאה צפויה באמצע יולי.
2026-07-05

DeepSeek קובעת 24 ביולי כמועד מוות לשמות מודלים ישנים ב-API — לקראת השקת V4
DeepSeek אישרה שהמזהים הישנים deepseek-chat ו-deepseek-reasoner יהפכו לבלתי נגישים אחרי ה-24 ביולי 2026 בשעה 15:59 UTC. מפתחים חייבים לעבור ל-deepseek-v4-flash ($0.14/$0.28 למיליון tokens) או ל-deepseek-v4-pro ($0.435/$0.87), שניהם עם חלונות הקשר של מיליון tokens ו-endpoint API בפורמט Anthropic. השחרור המלא של V4 מתוכנן לאמצע יולי עם תמחור peak/off-peak חדש.
2026-07-03

DeepSeek V4 מביא תמחור API לפי שעות עומס — כמו חברת חשמל, באמצע יולי
DeepSeek תשיק את V4 באמצע יולי עם מודל תמחור API חדש שמכפיל את העלויות בשעות השיא (9:00-12:00 ו-14:00-18:00 שעון בייג'ין), שינוי מתמחור אחיד שנועד לרכך קפיצות ביקוש ולהבטיח יציבות. V4 מציע context window של מיליון tokens וביצועים משופרים במשימות agentic, בהיסק מתמטי ובכתיבת קוד.
2026-07-02
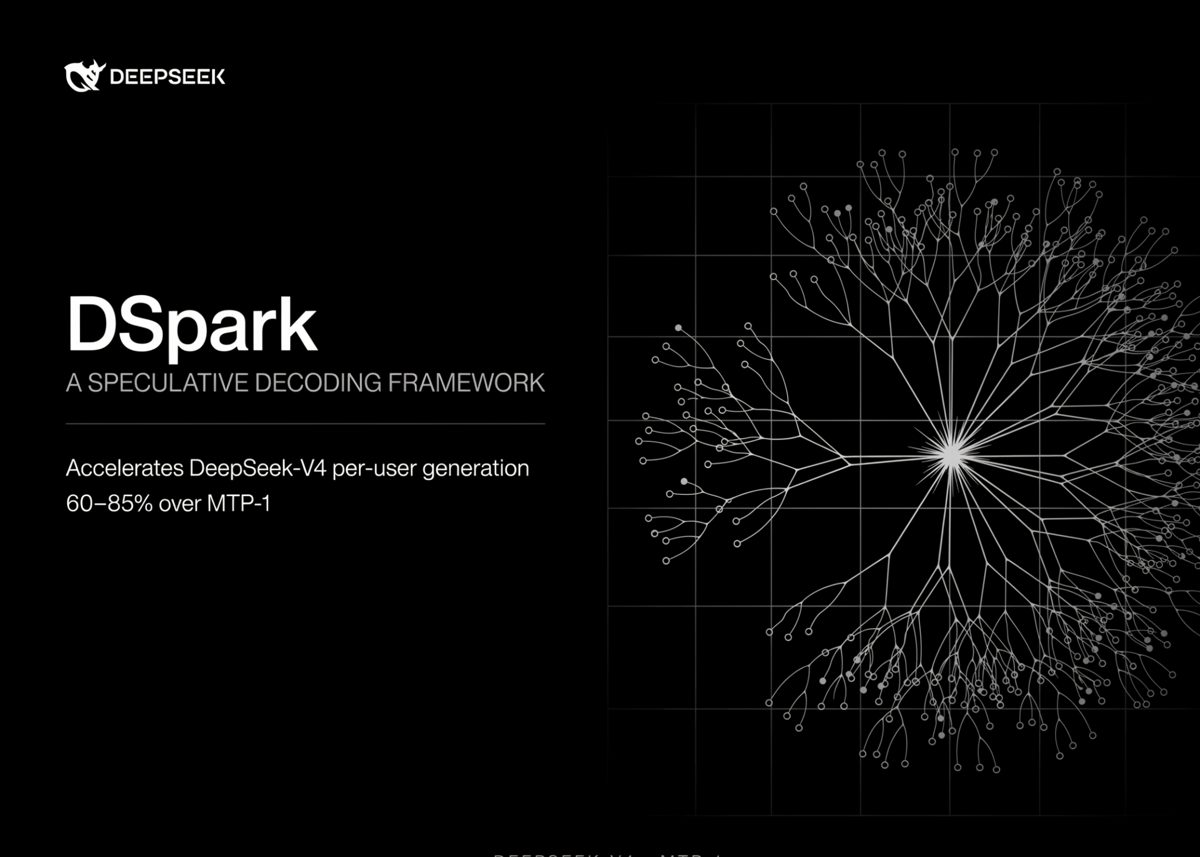
DeepSeek משחררת את DSpark: inference של V4 מהיר יותר בעד 85%
DeepSeek חשפה את DSpark, framework פתוח (ברישיון MIT) ל-speculative decoding עבור משפחת מודלי V4 שלה, שמאיץ את ה-inference ב-60%-85% ומאפשר ל-GPU יחיד לטפל בכ-185 שאילתות במקום 100. השחרור מגיע כש-DeepSeek מתכננת להכפיל לפחות את כוח האדם שלה, בגיבוי 7.4 מיליארד דולר שגייסה ביוני לפי שווי של מעל 50 מיליארד דולר.
2026-07-01
DeepSeek פותחת את DSpark ל-open-source — וטוענת לזירוז של עד 85%
DeepSeek השיקה את DSpark, framework open-source ברישיון MIT לאופטימיזציית inference שמאיץ את יצירת המודלים בעד 85% ללא שדרוג חומרה או אימון מחדש. בעזרת speculative decoding מתקדם, הוא כבר פעיל במודלי V4-Flash ו-V4-Pro של DeepSeek (האצה של 60%–85%) ותומך במודלים מספקים אחרים, כולל Qwen של Alibaba ו-Gemma של Google. הוא מגיע עם DeepSpec, codebase full-stack לאימון מודלי draft מותאמים אישית.
2026-06-30

DSpark של DeepSeek: speculative decoding שמאיץ את יצירת V4 בעד 85%
סטארטאפ ה-AI הסיני DeepSeek השיקה את DSpark, framework של speculative decoding שמגדיל את מהירות הייצור למשתמש במודל הדגל V4 ב-60%-85% לעומת MTP-1. בעזרת מודל draft קליל לצד אימות באצווה, הוא מצמצם את התלות בתשתית שבבים חזקה ומוזיל את עלויות ההגשה.
2026-06-29

DeepSeek מתכננת להכפיל כוח אדם אחרי גיוס של 7.4 מיליארד דולר בשווי 50 מיליארד+
DeepSeek, חברת ה-AI הסינית שהמודלים זולי-העלות שלה זעזעו את התעשייה, מוערכת כעת בלמעלה מ-50 מיליארד דולר אחרי שגייסה 7.4 מיליארד דולר בסבב הראשון שלה, ומתכננת להכפיל בערך את כוח האדם שלה. ההתרחבות מדגישה כמה חברות המודלים הפתוחים הסיניות ממומנות היטב ומתקדמות, בעוד המודלים המובילים של ארה"ב מתמודדים עם הגבלות ממשלתיות.
2026-06-29

DeepSeek מכפילה כוח אדם ב-27 תפקידים אחרי גיוס של 7.4 מיליארד דולר
DeepSeek מתכננת להכפיל את כוח האדם שלה ב-27 תפקידים טכניים בעקבות סבב גיוס ראשון של 7.4 מיליארד דולר לפי שווי של מעל 50 מיליארד דולר. בין המשקיעים שתמכו בגיוס: Tencent, CATL וקרן ההשקעות הלאומית של סין לתעשיית ה-AI, כשהמייסד Liang Wenfeng נותר עם כ-84% מההון, סעיף אי-חטיפת עובדים, ומשקיעים שנותרו ללא זכויות הצבעה תחת lockups של חמש שנים.
2026-06-28

DeepSeek מגייסת כ-7.4 מיליארד דולר לפי שווי 60 מיליארד — עם סעיף אי-חטיפה
DeepSeek השלימה את סבב הגיוס החיצוני הראשון שלה בכ-7.4 מיליארד דולר (50 מיליארד יואן), בשווי של 50–60 מיליארד דולר — הסטארטאפ הסיני בעל השווי הגבוה ביותר שעוסק אך ורק ב-AI. המייסד Liang Wenfeng השקיע אישית כ-3 מיליארד דולר והטיל סעיף איסור גיוס שמונע ממשקיעים, כולל Tencent ו-CATL, לגייס את עובדיו.
2026-06-25
DeepSeek V4 Flash מזניקה את סין לראש צריכת ה-token העולמית
DeepSeek V4 Flash דווח כמודל הנפוץ בעולם עם 4.63 טריליון token, ועזר למצב את סין כמובילה בשימוש ב-token של AI גלובלית. המודל ממנף אנרגיה זולה יותר ועיצוב יעיל במיוחד כדי להוזיל מחירים מתחת לחברות ה-AI המובילות בארה"ב, סימן ליתרון תחרותי הולך וגדל של חברות סיניות.
2026-06-21
DeepSeek מגייסת שיא של 7.4 מיליארד דולר בשווי 52 מיליארד — וארה״ב נמנעת מרשימה שחורה
חברת ה-AI הסינית DeepSeek סגרה סבב גיוס ראשון שיא של 7.4 מיליארד דולר מ-Tencent (כ-10 מיליארד יואן), CATL (כ-5 מיליארד יואן) וקרן ה-AI הלאומית של סין, כשהמייסד Liang Wenfeng הוסיף 20 מיליארד יואן באופן אישי — שווי של 52–59 מיליארד דולר. ב-16 ביוני ארה"ב בחרה שלא להוסיף את DeepSeek לרשימה השחורה למסחר למרות אישור בין-משרדי, במטרה להפחית מתחים עם בייג'ינג.
2026-06-18
DeepSeek חותכת מחירים ב-75%: מלחמת מחירי ה-AI הסינית יוצאת לדרך
DeepSeek חתכה את מחיר הדגל V4 Pro ב-75% — ל-0.0036 דולר למיליון input tokens ו-0.87 דולר למיליון output tokens — ומיצבה אותו כמוביל עולמי בביצועים-לדולר, מה שמכריח מתחרים וספקי ענן סיניים לכייל מחדש את התמחור על רקע סבב גיוס מתקרב.
2026-06-15
חיתוך מחיר של 75% ל-V4 Pro הופך את DeepSeek למלך הביצועים-לדולר
DeepSeek הכריזה על הוזלת מחיר קבועה של 75% למודל הדגל V4 Pro, והורידה את מחיר ה-API ל-0.0036$ למיליון input tokens. המהלך, שמתאפשר הודות לשרשרת אספקת שבבי ה-AI המקומית של סין, הופך את V4 Pro למוביל העולמי ב'יעילות ביצועי AI לדולר' לפי Artificial Analysis, חותך מתחת ל-GPT-5.5 ודוחף את DeepSeek לראש טבלת השימוש השבועי ב-tokens של OpenRouter.
2026-06-12
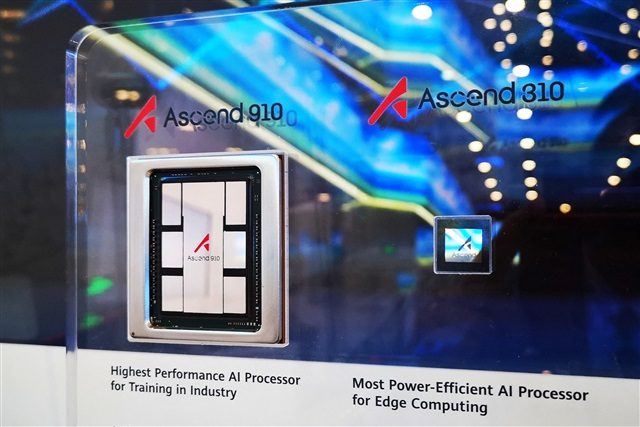
DeepSeek עוקפת את Nvidia: אימון ענק הושלם כולו על שבבי Huawei
חוקרים סיניים, בשיתוף Huawei ומוסדות בשנזן, השלימו לפי הדיווחים post-training מלא של כל הפרמטרים במודל V4-Pro של DeepSeek — מודל של כ-1.6 טריליון פרמטרים — באמצעות יותר מ-1,000 שבבי Huawei Ascend 910C, בלי חומרה של Nvidia כלל. ההישג מסמן ששבבים מתוצרת מקומית יכולים לתמוך בעומסי אימון אינטנסיביים של AI — צעד משמעותי לעצמאות החומרה של סין.
2026-06-11
DeepSeek בראש מדד הספקים החמים של Ramp — חברות אמריקאיות זורמות ל-API הזול V4
DeepSeek דורגה במקום הראשון במדד ספקי התוכנה החמים של Ramp ליוני 2026, סימן לקפיצה באימוץ בקרב עסקים בארה"ב. הזינוק מונע מהמחיר: DeepSeek V4 מציעה תמחור API נמוך בהרבה מהמתחרות, מה שגורם לחברות אמריקאיות לשלם לה ישירות ולנתב דרכה נתונים — למרות אזהרות אבטחה.
2026-06-09
DeepSeek בראש רשימת הספקים החמים — וחברות בארה״ב מתחילות לשלם ישירות
DeepSeek הובילה את רשימת ספקי התוכנה החמים של Ramp ליוני 2026, כשחברות אמריקאיות לראשונה משלמות ישירות עבור שירותי ה-AI שלה במקום לארח בעצמן את המודלים ה-open-source שלה. המעבר מסמן ביקוש עסקי גובר לחלופות AI זולות, גם אם מודל ה-V4 של DeepSeek מפגר אחרי המערכות המערביות המובילות בביצועים כוללים. משתלמות-העלות היא המשיכה הדומיננטית.
2026-06-08
שבבי Ascend של Huawei השלימו post-training מלא של DeepSeek-V4
צוות מחקר שכולל את Huawei טוען שהשתמש בשבבי Ascend 910C כדי להשלים post-training מלא של מודל DeepSeek-V4-Pro בן 1.6 טריליון פרמטרים על cluster של לפחות 1,000 שבבים של Huawei — צעד משמעותי לעצמאות ה-AI של סין, שעוברת מ-inference למשימה הקשה יותר של אימון תחת הסנקציות האמריקאיות.
2026-06-07
DeepSeek לקראת סבב של 7.4 מיליארד דולר מ-Tencent ו-CATL, סגירה ב-11 ביוני
DeepSeek משלימה גיוס של 50 מיליארד יואן (כ-7.4 מיליארד דולר) ממשקיעים שכוללים את Tencent ואת יצרנית הסוללות CATL, שמיועד לפיתוח מודלי frontier ולהרחבת תשתית. הסבב צפוי להיסגר ב-11 ביוני, וממצב את DeepSeek בין מקבלות ההון הגדולות במרוץ ה-AI.
2026-06-06
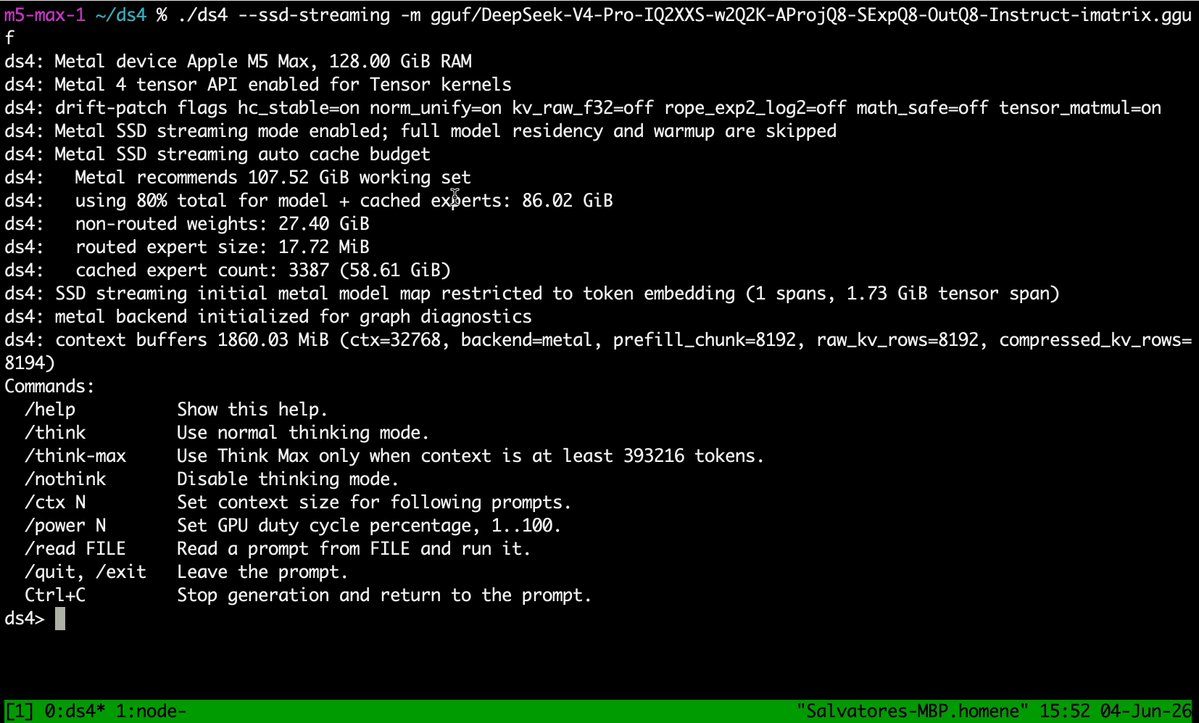
הדגמה: מודל DeepSeek עם 1.6 טריליון פרמטרים רץ על MacBook M5 Max דרך SSD
מודל DeepSeek עם 1.6 טריליון פרמטרים, ככל הנראה גרסה של DeepSeek v4 PRO, הודגם רץ על MacBook M5 Max באמצעות זיכרון מגובה SSD. ההדגמה מדגישה את הניידות הגוברת של מודלים בקנה מידה חזיתי על חומרה צרכנית, ואת ההתקדמות באופטימיזציה של מודלים גדולים ל-inference מקומי יעיל ללא תשתית ענן.
2026-06-05
הונג קונג משיקה את HKGAI-V3 מבוסס DeepSeek, ממוטב לשבבים מקומיים
ה-Hong Kong Generative AI R&D Centre השיק את HKGAI-V3, מודל שפה גדול הבנוי על DeepSeek V4 ומותאם לריצה על שבבים מקומיים. הוא טוען ליותר מפי-עשרה דחיסת token ולפי-מאה כמעט בזמן ריצה רצוף של agent, עם פלטפורמת AI agent שרצה ביציבות עד 28 שעות.
2026-06-04
DeepSeek חותכת לצמיתות 75% ממחיר ה-API של המודל המוביל שלה
סטארטאפ ה-AI הסיני DeepSeek הכריז על הוזלה קבועה של 75% במחיר ה-API של מודל הדגל שלו, החל מ-1 ביוני. התמחור האגרסיבי מייצר דיון בכל תעשיית ה-AI הגלובלית, כשאנליסטים מעריכים שהוא עלול ללחוץ על פיתוח תשתיות AI ולהצית מחדש את מלחמת ה-price-performance בין ספקי המודלים.
2026-06-02
DeepSeek קובעת עובדה: הנחת 75% הפכה קבועה, ועוד 90% על cached tokens
DeepSeek הפכה את הנחת ה-API הזמנית של 75% על V4-Pro לקבועה, והוסיפה מעליה הנחה של 90% על cached tokens. התוצאה: מודל ה-reasoning המוביל שלה עולה בערך רבע ממחיר ה-tokens המקבילים של OpenAI או Anthropic — הסלמה חדה במלחמת המחירים הגלובלית לקראת גל ההשקות האמריקאי של הקיץ.
2026-05-28
DeepSeek חותכת 75% במחיר ה-API — ומציתה מחדש את דיון "בועת ה-AI האמריקאית"
DeepSeek הכריזה על הורדת מחיר קבועה של 75% למודל V4-Pro שלה, והורידה את גישת ה-API ל-0.0036 דולר למיליון cached input tokens ו-0.87 דולר למיליון output tokens — מהלך cost-leadership ישיר נגד OpenAI, Anthropic ו-Meta. הקיצוץ החייה את הנרטיב של 'בועת ה-AI האמריקאית' ברדיט וב-HN, עם thread אחד ב-r/OpenAI שצבר 1,222 upvotes.
2026-05-27
DeepSeek מקבעת את הנחת ה-75%: מלחמת המחירים ב-AI עולה הילוך
DeepSeek אישרה שההנחה של 75% על דגל V4-Pro היא קבועה ולא מבצע, עם תמחור API שיורד עד 0.003625 דולר למיליון tokens — בערך פי 100 זול מ-GPT-5.5 שעולה 30 דולר למיליון output tokens. החברה מייחסת את ההפחתה לשיפורי efficiency אמיתיים ב-long-context inference, ולפי הדיווחים נערכת לסבב גיוס חדש.
2026-05-26

DeepSeek קובעת מחיר חדש: הפחתת 75% ב-V4-Pro הופכת קבועה ומתמחרת מחדש את ה-intelligence-per-dollar
סטארטאפ ה-AI הסיני DeepSeek אישר שיותיר באופן קבוע הנחה של 75% על מודל הדגל V4-Pro, ויוריד את תמחור ה-API לטווח של 0.025 עד 6 יואן למיליון tokens. המהלך ממצב את V4-Pro בין הטובים בעולם ביחס אינטליגנציה-לדולר, ומשקף מגמה רחבה של הפחתת תלות בחומרת NVIDIA לטובת חלופות מקומיות.
2026-05-25
DeepSeek הופכת את ההנחה ב-V4-Pro/Flash לקבועה
DeepSeek הודיעה שההנחה ב-API הופכת לקבועה, ומקבעת תמחור נמוך עבור DeepSeek-V4-Pro (1.6T סך הכל / 49B active params, context של 1M) ו-V4-Flash (284B סך הכל / 13B active params). המהלך מבסס את DeepSeek כמוביל המחיר בשכבת ה-API ברמת frontier, בדיוק כש-Alibaba מסתירה את המודלים החזקים של Qwen מאחורי paywall.
2026-05-23

DeepSeek משיקה מוצרי agent — ומכפילה הימור על agentic AI
DeepSeek נערכת להשיק מוצרי agent חכמים, ומאמצת את הגישה שהנדסת AI נעה לעבר בניית סביבות הפעלה שלמות ל-agents. החברה שחררה ב-24 באפריל preview של מודל V4 שלה, עם ביצועים חזקים ב-benchmarks של agentic coding — ועכשיו הופכת את היכולת הזו למוצר.
2026-05-21
DeepSeek V4 Flash ו-V4 Pro יוצאים עם שכבת agentic-coding בגודל 1.6 טריליון פרמטרים
DeepSeek שחררה את V4 Flash ו-V4 Pro וממשיכה במהלך מחיר-ביצועים. V4 Flash הוא MoE מאופטם ליעילות, מותאם למהירות ול-pipelines בנפח גבוה; V4 Pro מגיע עם 1.6 טריליון פרמטרים בסך הכל ומכוון ל-reasoning עמוק ולקוד agentic רב-שלבי. הפיצול תואם את מגמת התעשייה של רמות Pro/Flash במקום מודל בסיס יחיד.
2026-05-20
DeepSeek-V4-Flash ו-V4-Pro שוחררו כמודלים open-weight עם hybrid attention ו-13B פרמטרים פעילים
DeepSeek שחררה את V4-Flash (284B סה"כ / 13B פעילים) ואת V4-Pro כמודלים open-weight על Hugging Face. שניהם מותאמים ל-agentic coding וליעילות long-context, עם חידושים מבניים כמו hybrid attention ו-DeepSeek Sparse Attention להפחתת compute וזיכרון. V4-Flash ממוצב כאופציה חסכונית למפתחים שבונים workflows מבוססי long-context ו-agents.
2026-05-18
DeepSeek-V4 Pro (MoE של 1.6T-A49B) ו-V4 Flash שוחררו כ-open weights
DeepSeek שחררה את סדרת V4 ב-Hugging Face, כולל גרסת Pro של MoE בגודל 1.6T-A49B וגרסת Flash של 284B-13B. מודל ה-Flash בולט בביצועים חזקים יחסית לגודלו ובשינויים ארכיטקטוניים שמשפרים ומוזילים יכולות long-context.
2026-05-17
DeepSeek חושפת תצוגה מקדימה של V4: 1.6T פרמטרים, context של 1M, חיתוך 75% במחיר ה-API
DeepSeek-V4 preview יוצא עם 1.6T פרמטרים סה"כ ו-49B פעילים בארכיטקטורת MoE, חלון context של מיליון tokens, ו-KV cache קטן פי 10 שמכוון ל-workloads של agents. גרסת V4-Flash מציעה 284B/13B. מחירי ה-API ירדו ב-75% ועלויות ה-cache ב-90%; ה-benchmarks לא ממש סוגרים את הפער מהחזית.
2026-05-17
DeepSeek V4 רץ על שבבי Huawei, Stanford HAI קובע שפער ה-AI בין ארה״ב לסין "נסגר למעשה"
תצוגה מקדימה של DeepSeek V4 רצה על שבבים של Huawei במקום של Nvidia, סימן לירידה בתלות סינית ביצרניות שבבים אמריקאיות. דוח של Stanford Institute for Human-Centered AI קובע שהפער בין מודלי ה-AI המובילים בארה\"ב לסין 'נסגר כמעט לחלוטין', כש-DeepSeek V4 ממוטב במפורש ליעילות עלות על חומרה זמינה.
2026-05-15
DeepSeek V4 מתקרב לרמת GPT-5 לפי הערכת CAISI האמריקאית
המודל DeepSeek V4 (1.6T פרמטרים, רישיון MIT) הוערך על ידי ה-U.S. AI Standards and Innovation Center כמתפקד דומה ל-GPT-5 של OpenAI (אוגוסט 2025), מה שהופך אותו למודל ה-AI הסיני הטוב ביותר — אם כי עדיין מפגר אחרי המודלים האמריקאים החדשים בכ-8 חודשים. cost efficiency צוין כחוזקה.
2026-05-14
DeepSeek V4-Pro: 1.6 טריליון params, context של מיליון tokens, עלות inference נמוכה משמעותית — מאלץ לפי הדיווחים הורדת מחיר של Anthropic
DeepSeek שחררה את V4 דרך API ב-24 באפריל 2026, עם וריאנט Pro שכולל 1.6 טריליון פרמטרים ו-context window של מיליון tokens. V4-Pro דורש משמעותית פחות inference FLOPs ו-KV-cache מ-V3.2, מה שהופך אותו לתחרותי ללולאות agent-יות ועבודה על codebases גדולים. ההשקה הסעירה את כלכלת ה-AI — לפי הדיווחים Anthropic הורידה את מחירי Opus 4.7 בתגובה, ו-DeepSeek גם מבצעת אופטימיזציה של המודל לשבבי Huawei.
2026-05-13
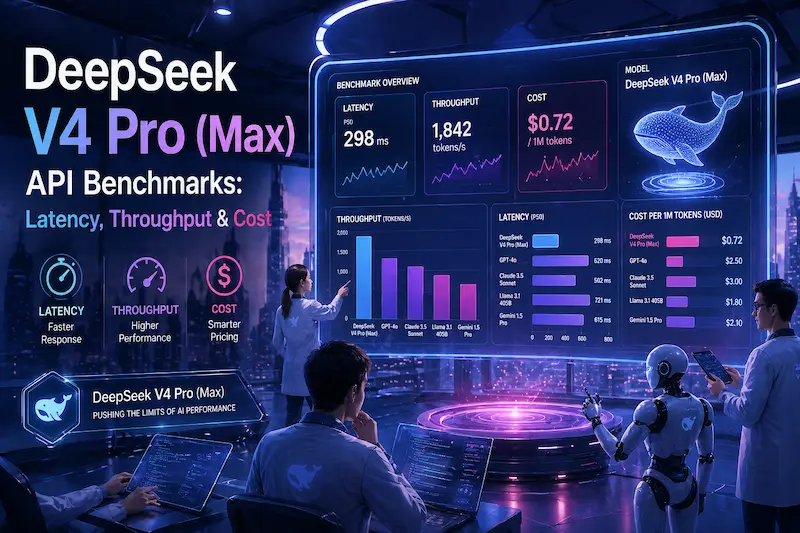
DeepSeek V4-Pro חוצה 150+ tok/sec/user על GB200 NVL72, מתחרה ב-frontier בשבריר מהעלות
DeepSeek V4-Pro, ששוחרר דרך API ב-24 באפריל, אורז 1.6 טריליון פרמטרים בסך הכול וחלון context של מיליון tokens, ומספק יותר מ-150 tokens/sec למשתמש על פלטפורמת GB200 NVL72 של NVIDIA. לפי הדיווחים הוא משתווה ל-Claude Opus 4.7 ול-GPT-5.5 ב-workflows אג'נטיים כבדי-קוד, בעלות שולית בלבד, ו-V4 אומן לפי הדיווחים ב-7.8 מיליון דולר.
2026-05-11
DeepSeek V4 שוברת את המתמטיקה של 500 מיליארד דולר capex ב-AI; Anthropic חותכת את התמחור של Opus 4.7 ב-67%
DeepSeek V4 Pro (1.6T פרמטרים בסך הכל, 49B פעילים לכל token דרך MoE, context של 1M tokens) הושק דרך API ב-24 באפריל ודורש רק 27% מה-inference FLOPs ל-token יחיד של V3.2 ו-10% מה-KV cache שלו ב-context מלא. שיפורי היעילות דוחפים את תמחור ה-API כלפי מטה בכל התעשייה — Anthropic הורידה את מחירי Claude Opus 4.7 ב-67% לאחר השקת V4.
2026-05-11
יצרניות שבבים סיניות משלבות את DeepSeek V4 לרוחב חומרה מקומית
יצרניות שבבים סיניות, כולל Huawei ו-Cambricon, משלבות במהירות את ה-LLM בשם V4 של DeepSeek בפלטפורמות מקומיות. Huawei התאימה את V4 לשבב Ascend 950PR שלה, ולפי הדיווחים השיגה ביצועי inference פי 2.87 ב-card יחיד ביחס ל-H20 של NVIDIA, ושיפור של 60% ביעילות יצירה מולטי-מודלית בעלות deploy נמוכה יותר.
2026-05-09
DeepSeek מתקרבת לשווי 45 מיליארד דולר בסבב בהובלת Big Fund הסיני עם Tencent ו-Alibaba
DeepSeek סוגרת סבב גיוס בשווי של כמעט 45 מיליארד דולר — בערך פי 4 מהשווי שלה לפני שבועיים — בהובלת China Integrated Circuit Industry Investment Fund ('Big Fund') ובהשתתפות Tencent ו-Alibaba. החברה מתכננת להגדיל compute, לגייס באגרסיביות ולהעמיק תאימות ל-chips של Huawei כדי להפחית תלות ב-NVIDIA.
2026-05-07
DeepSeek V4 משיקה עם context של מיליון tokens ו-open weights בזמן שהשווי קופץ ל-45 מיליארד דולר
DeepSeek שחררה את V4 בגרסאות 'Pro' (1.6T פרמטרים) ו-'Flash' (284B) עם חלון context של מיליון tokens ו-open weights, שעבר אופטימיזציה ל-coding agentic, מחקר וניתוח מסמכים. FT ו-Bloomberg מדווחים ש-DeepSeek במו"מ לסבב VC ראשון בשווי 45 מיליארד דולר — קפיצה מ-20 מיליארד לפני שבועות בלבד — ו-V4 כוונן ל-inference על שבב 950PR של Huawei, אם כי האימון עצמו עדיין רץ על NVIDIA.
2026-05-07
DeepSeek סוגרת סבב גיוס של 50 מיליארד דולר בהובלת קרן ה-AI הלאומית של סין
DeepSeek סוגרת סבב גיוס שצפוי לתמחר את מעבדת ה-AI הסינית בכ-50 מיליארד דולר (מעל 300 מיליארד יואן), כשקרן ה-AI הלאומית של סין במגעים להוביל את הסבב, ו-Alibaba ו-Tencent מוזכרות כמשקיעות אפשריות. הגיוס מדגיש את הגיבוי האסטרטגי של בייג'ינג ל-AI מקומי, על רקע שבבי Huawei 950PR שמפעילים את ה-inference של V4.
2026-05-06
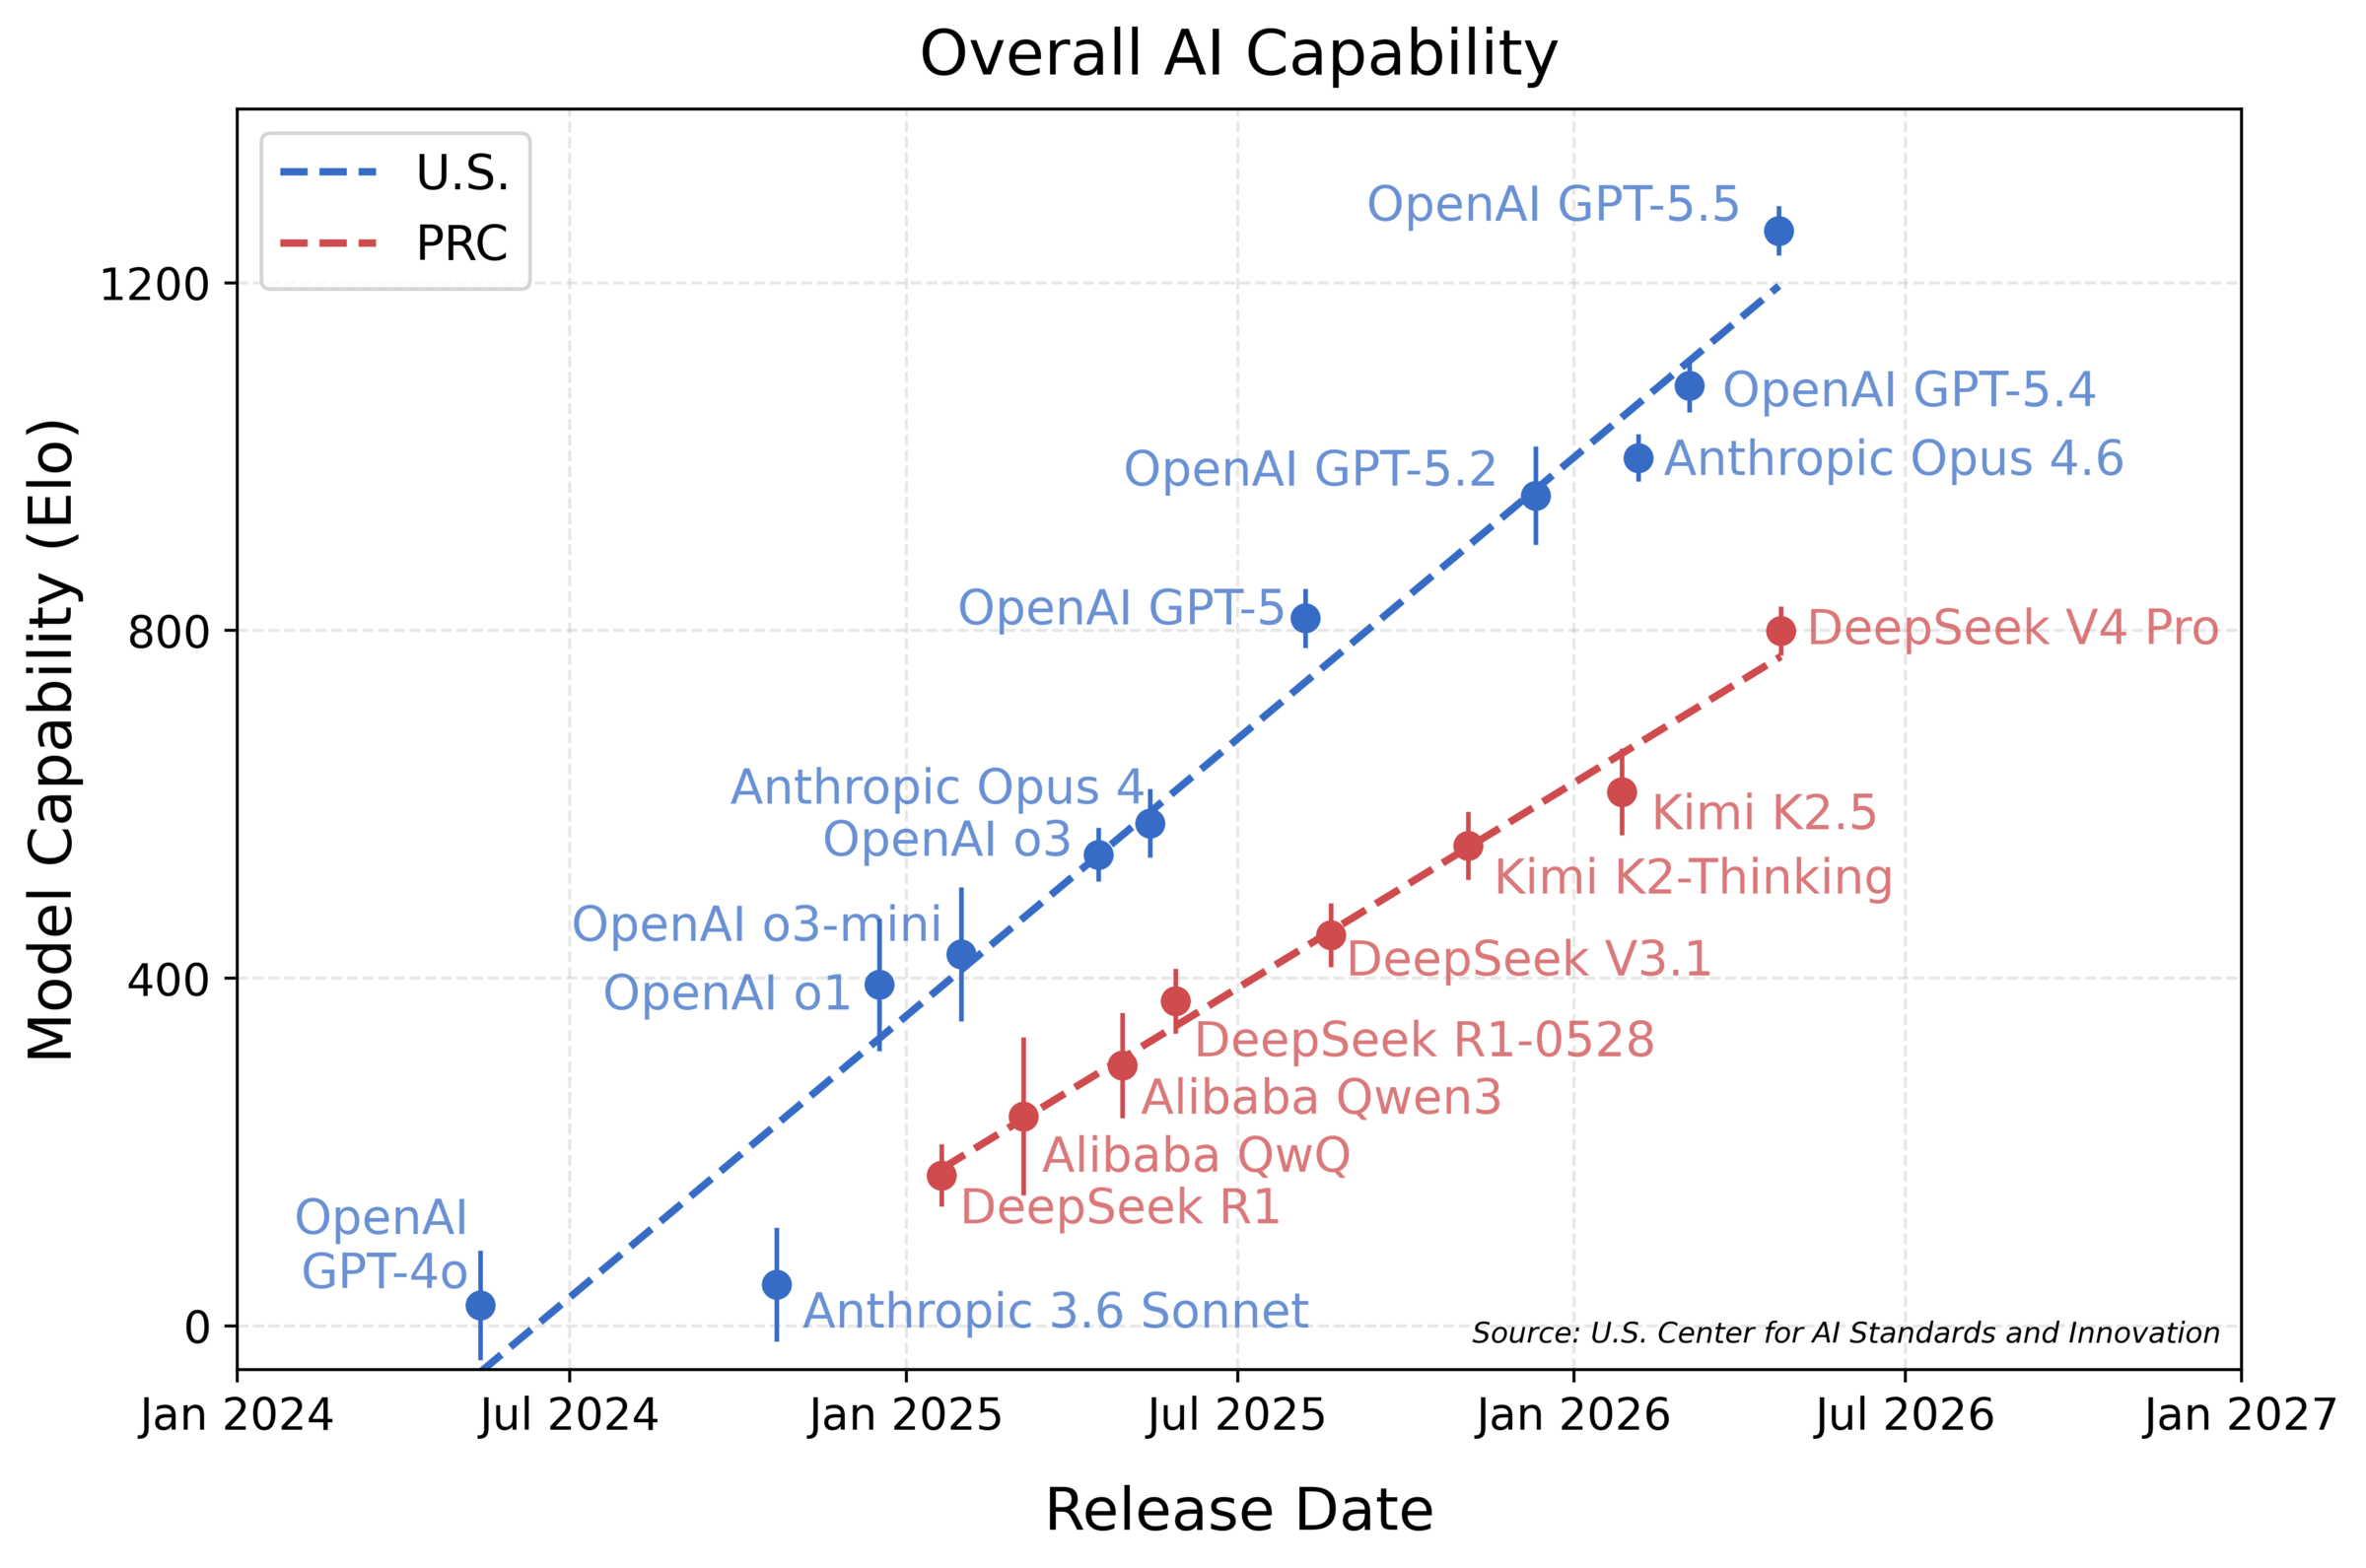
DeepSeek V4 (1.6T פרמטרים) הושק ב-97% מתחת למחיר GPT-5.5, בנוי על Huawei Ascend ו-Cambricon
DeepSeek שחררה את מודל ה-V4 שלה, כשהווריאנט V4-Pro מציג 1.6 טריליון פרמטרים וחלון context של מיליון tokens, בנוי בעיקר על סיליקון סיני מקומי (Huawei Ascend, Cambricon) ולא על NVIDIA. V4 הושק עם תמחור אגרסיבי — 97% מתחת ל-GPT-5.5 של OpenAI — עם תאימות API שמורידה את עלויות המעבר למינימום. NIST CAISI פרסמה הערכה, וה-NYT טוען ש-DeepSeek משנה את המבנה של מירוץ ה-AI הגלובלי.
2026-05-05
NYT: ההשקה האחרונה של DeepSeek משנה את מירוץ ה-AI בין ארה״ב לסין
ה-NYT טוען שהמודל החדש של DeepSeek לא רק יישר את סין מול ארה\"ב, אלא שינה את אופי המרוץ עצמו, באמצעות reasoning חסכוני. CAISI דירגה במקביל את DeepSeek V4 Pro כמודל הסיני החזק ביותר, אם כי עדיין מפגר בכ-8 חודשים אחרי החזית האמריקאית.
2026-05-04
DeepSeek חשפה V4-Pro (1.6T) ו-V4-Flash עם context של מיליון טוקנים
DeepSeek חשפה preview של V4 בשתי גרסאות: V4-Pro עם 1.6T פרמטרים ו-V4-Flash עם 284B, שתיהן עם context של 1M tokens. open-source ברישיון MIT, עם תמיכת vLLM מהיום הראשון ותמחור נמוך משמעותית מהמעבדות האמריקאיות. ביצועים חזקים ב-benchmarks של agents וקוד שמתחרים במערכות closed-source.
2026-05-01
DeepSeek V4 משיק עם context של מיליון, open weights ברישיון MIT — אבל השווקים מגיבים באדישות
DeepSeek שחררה ב-24 באפריל את מודלי ה-preview של V4-Pro ו-V4-Flash תחת open weights ברישיון MIT עם 1M context, בתמחור API נמוך באורדר של גודל מהמתחרים המערביים. השוק הגיב בקרירות — Lian Jye Su מ-Omdia הגדיר את ההכרזה כצפויה, מאחר ששיפורי ארכיטקטורה ויעילות הפכו לנחלת הכלל.
2026-04-30
DeepSeek V4 (1.6T פרמטרים, 1M context) רץ על שבבי Huawei עם חיתוכי מחיר אגרסיביים
DeepSeek חשפה preview של V4, המודל החזק ביותר שלה עד היום — 1.6 טריליון פרמטרים, חלון context של מיליון tokens, אומן על שבבי Huawei — וגזרה את המחיר של הדגל החדש כדי לחתוך מתחת למתחרים מערביים וסיניים. השוק הגדיר את ההתקדמות הארכיטקטונית כ-'צפויה' וההשקה לא הרשימה אנליסטים.
2026-04-29
DeepSeek V4 משיקה עם 1.6 טריליון פרמטרים, תמיכת day-0 ב-Blackwell והפחתות מחיר אגרסיביות
DeepSeek השיקה ב-24 באפריל את V4 ב-preview בשתי גרסאות: V4-Pro עם 1.6 טריליון פרמטרים ו-V4-Flash עם 284 מיליארד, שתיהן תומכות ב-context של עד מיליון tokens ומשתמשות ב-27% בלבד מ-FLOPs של inference לכל token וב-10% מ-KV cache בהשוואה למודלים מובילים קודמים. NVIDIA סיפקה תמיכת Blackwell ביום ההשקה עם 3,500 tokens בשנייה על מודל ה-1.6T דרך NVFP4, ו-DeepSeek קיצצה דרסטית את התמחור הדגל כדי ללחוץ על המתחרים האמריקאים — אם כי Reuters מציינת שהשווקים כבר לא מתרשמים.
2026-04-28
תצוגה מקדימה של DeepSeek V4: 1.6T MoE, 1M context, Apache 2.0 — וצעד לכיוון Huawei Ascend
DeepSeek חשפה גרסת preview של V4-Pro-Max (1.6T פרמטרים) ו-V4 Flash (284B) — מודלי MoE עם חלון של 1M tokens, open-weighted תחת Apache 2.0, בתמחור API של $1.74/$3.48 למיליון tokens. השחרור מציג Compressed Sparse Attention יחד עם Heavily Compressed Attention, שחותכים את ה-KV cache פי ~10 בהקשר של 1M ומשתמשים רק ב-27% מ-FLOPs של inference לכל token לעומת V3.2. חשוב לא פחות — DeepSeek הוכיחה שניתן להריץ fine-grained Expert Parallelism על Huawei Ascend NPUs בהאצה של 1.5–1.73x, מתווה שעמיד מול בקרת היצוא האמריקאית.
2026-04-27
השקת DeepSeek V4 צפויה השבוע עם טריליון פרמטרים
השקת DeepSeek V4 צפויה מאוד השבוע בעקבות ציוצים של אנשי פנים בתעשייה, עם ציפיות ל-1 טריליון פרמטרים כוללים ו-32-37 מיליארד פרמטרים אקטיביים דרך ארכיטקטורת MoE. המודל מותאם לשבבי Huawei בעקבות הגבלות יצוא אמריקניות ומתחים גיאופוליטיים.
2026-04-20
DeepSeek V4 צפוי בסוף April עם טריליון פרמטרים מותאמים לצ'יפים של Huawei Ascend
DeepSeek V4 צפוי בסוף אפריל 2026 עם כ-1 טריליון פרמטרים סה"כ באמצעות ארכיטקטורת Mixture-of-Experts עם רק 32-37 מיליארד פרמטרים פעילים לכל token. המודל החמיץ שני חלונות השקה קודמים אבל מייצג את המודל מהחזית הראשון המותאם לשבבים מקומיים סיניים אחרי חודשי שיתוף פעולה עם Huawei ו-Cambricon.
2026-04-18